




داده کاوی (Data Mining) و مفاهیم کلیدی آن – راهنمای جامع و ساده


مفاهیم مقدماتی
نویز
«نویز» (Noise | نوفه) از یک سو، در تعریف به نمادها و سمبلها و یا دادههای ایجاد شده به صورت تصادفی که فاقد معنای خاصی هستند گفته میشود. بر همین اساس، گاهی دادههایی که دارای خطا هستند نویزی (دارای نویز) نامیده میشوند. از جمله این دادهها میتوان به «مقادیر ناموجود» (Missing Values) و مقادیر غلط (مانند عدد ۲۰۰۰ برای وزن یک انسان) اشاره کرد. از سوی دیگر، تفاوت بین یک مدل و پیشبینیهای آن را نویز گویند.
داده
«داده»ها (Data) نمادها و سمبلهای خامی هستند که به تنهایی فاقد معنای کامل هستند. از جمله دادهها میتوان به تراکنشها، اعداد، متن، تصاویر و ویدئوها اشاره کرد.
قالب داده
اقلام داده ممکن است در قالبهای گوناگون مانند متن، اعداد صحیح، اعداد اعشاری، تصاویر و ویدئوها باشند. نوع داده در «پایگاه داده» (Database) را «قالب داده» (Data Format) گویند.
دادههای خارجی
«دادههای خارجی» (External Data)، دادههایی هستند که در داخل یک سازمان گردآوری و ذخیره نشدهاند. از جمله این دادهها میتوان به دادههای موجود در کتابهای مرجع، منابع داده دولتی و دادههای وب اشاره کرد.
دادههای داخلی
دادههای گردآوری شده در یک سازمان مانند دادههای مشتریان و عملیات سازمانی را «دادههای داخلی» (Internal Data) گویند.
Overlay
دادههایی که توسط سازمان گردآوری نشدهاند، مانند دادههای پایگاه داده اختصاصی که با دادههای خود سازمان ترکیب میشوند را «Overlay» گویند.
داده کاوی
«دادهکاوی» (Data Mining)، علمی میانرشتهای شامل الگوریتمهای «یادگیری ماشین» (Machine Learning)، روشهای آماری و «سیستمهای مدیریت پایگاه داده» (Database Management Systems) به شمار میآید. هدف از انجام فرآیند دادهکاوی کشف الگوهای مهم و جالب توجه در میان حجم انبوه دادهها است.


موتور دادهکاوی
«موتور دادهکاوی» (Data Mining Engine) قلب حقیقی معماری دادهکاوی محسوب میشود و شامل ابزارها و نرمافزارهایی است که برای کسب بینش و دانش از دادههای کسب شده از منبع داده و ذخیره شده در «انبار داده» (Data Warehouse) به کار گرفته میشوند. یک موتور دادهکاوی قدرتمند دارای سه مولفه اساسی است که در ادامه بیان شدهاند.

- موتور دادهکاوی نیازمند مفسر است. مفسر میتواند دستورات تعریف شده در موتور دادهکاوی را به کامپیوتر انتقال دهد.
- نیاز به چرخدندههای ارتباطی بین موتور دادهکاوی و انبار داده برای تولید و مدیریت ارتباطات این دو در هر دو جهت وجود دارد.
- نیاز به دستورالعملها و الگوریتمهایی برای هدایت فرآیند دادهکاوی است.
پایگاه دانش
«پایگاه دانش» (Knowledge Base) دامنهای از دانش و در واقع فناوری مورد استفاده برای ذخیرهسازی دادههای پیچیده ساخت یافته و غیر ساخت یافته است. از این پایگاه برای هدایت کردن اکتشافات در فرآیند دادهکاوی شامل گامهای «پاکسازی دادهها» (Cleaning of data)، یکپارچهسازی دادهها، انتخاب داده، تبدیل دادهها، دادهکاوی، ارزیابی الگو و ارائه دانش استفاده میشود.
دادههای ناموجود
امکان دارد مقادیر داده به دلایل گوناگون شامل اندازهگیری نشدن (مثلا در پایگاه داده اطلاعات کودکان مبتلا به تالاسمی قد فرد اندازهگیری نشده و بدون مقدار است)، پاسخ داده نشدن به پرسش موجود در فرمها (مثلا فرد مشخص نکرده که گواهینامه رانندگی دارد یا خیر)، ناشناخته بودن مقادیر (مثلا عدد اشتباه برای سن فرد وارد شده) یا گم شدن دادهها وجود نداشته باشند.

این دادهها، «داده ناموجود» (Missing data) محسوب میشوند. روشهای دادهکاوی بسته به گونهای که با دادههای ناموجود برخورد میکنند متفاوت هستند.

دادههای غیر قابل اجرا
مقادیر ناموجودی که به لحاظ منطقی غیر ممکن هستند و یا طور مشخص مرتبط با دامنهای که برای آن وارد شدهاند نیستند را «دادههای غیر قابل اجرا» (Non-applicable Data) گویند.
پاکسازی
پاکسازی دادهها (Cleaning | Cleansing)، یک گام از فرآیند دادهکاوی و جزئی از پیشپردازش دادهها محسوب میشود که طی آن دادهها برای فعالیتهای دادهکاوی آمادهسازی میشوند. خطاهای آشکار دادهها در این مرحله شناسایی، اصلاح و «دادههای ناموجود» (Missing Data) با مقادیری (این مقادیر به روشهای گوناگون قابل محاسبه هستند) جایگزین میشوند.
یکپارچهسازی دادهها
«یکپارچهسازی دادهها» (Data Integration)، یکی از گامهای فرآیند دادهکاوی و از مراحل پیشپردازش دادهها است. از این کار برای ادغام دادههای گردآوری شده از منابع داده ناهمگون در یک مخزن داده همبسته استفاده میشود. این مخزن در برگیرنده دادههای ناسازگار است، بنابراین نیاز به پاکسازی دادهها در آن وجود دارد.
تبدیل
«تبدیل» (Transformation) یک گام از فرآیند دادهکاوی و پیش پردازش دادهها است. در این گام یک بیان مجدد از دادهها با انجام تجمیع دوباره، نرمالسازی و تغییر واحدهای اندازهگیری آنها ارائه میشود.
بصریسازی

استقرار
هنگامی که مدل ساخته و اعتبارسنجی شد، از آن برای تحلیل دادههای جدید و انجام پیشبینی استفاده میشود. بنابراین، به استفاده از مدل «استقرار» (Deployment) گفته میشود.
DBMS
RDBMS
«RDBMS» سرنامی برای «Relational Database Management System» (سیستم مدیریت پایگاه داده رابطهای) است. این سیستم در واقع پایگاه دادهای ساخته شده بر اساس مدل رابطهای است.
رابط کاربری
«رابط کاربری» (User Interface | UI) در معنای عام به فضایی گفته میشود که تعامل میان انسان و ماشین رخ میدهد. در واقع رابط کاربری بخش قابل مشاهده از یک ابزار است که کاربر آن را مشاهده میکند. در دادهکاوی نیز آن بخش از نرمافزارها و ابزارهای مورد استفاده که برای کاربر قابل مشاهده است (چه در ابزارهای پایگاه داده و چه زبانهای برنامهنویسی مانند پایتون و R که برای انجام تحلیل به کار میروند) رابط کاربری محسوب میشود. برخی از نقشهای رابط کاربری در ادامه بیان شدهاند.
- رابط انسان و ماشین جهت تعیین وظایف «پرسوجوی» (Query) دادهکاوی
- فراهم کردن اطلاعات برای کمک به متمرکزسازی جستوجوها
- کاوش بر اساس نتایج میانی دادهکاوی
- مرور شمای پایگاه داده و انبار داده یا ساختارهای داده
- ارزیابی الگوهای کاوش شده
- بصریسازی الگوها به اشکال گوناگون

انواع ویژگی
پیوسته
گسسته
یک قلم داده که دارای مجموعه متناهی از مقادیر است را «گسسته» گویند. گسسته در اینجا متضاد «پیوسته» است.
دادههای دستهای
بستهبندی
«بستهبندی» (Binning) یکی از روشهای آمادهسازی دادهها طی فرآیند کاوش جهت تبدیل دادههای پیوسته به گسسته است. در این روش، نیاز به جایگزینی یک مقدار از طیف پیوسته با یک شناساگر «بسته» (bin) است.
ابعاد

جبر خطی و آمار
میانگین
میانه
مقدار موجود در وسط مجموعهای از دادههای مرتب شده را میانه گویند. به بیان دیگر، مقداری با تعداد مقادیر پیشین و پسین مشابه را میانه گویند.
مُد
یک نقطه تصمیمگیری در دستهبندی مقدار مُد (Mode) است. اگر بیش از یک مقدار دارای تعداد تکرار مشابهی باشد، داده «چندمدلی» (multi-model) است.

نرمالسازی
کمترین مربعات
«کمترین مربعات» (Least Squares) متداولترین روش آموزش وزنهای مدل است. بدین منظور، نیاز به انتخاب وزنهایی است که انحراف مجموع مربعات از مقادیر پیشبینی شده مدل را کمینه کنند. این کار با استفاده از مقادیر مشاهده شده دادهها امکانپذیر است.
واریانس
«واریانس» (Variance) پر کاربردترین سنجه آماری مورد استفاده برای پراکندگی است. در محاسبه واریانس، گام اول آن است که مربع انحراف اقلام داده از مقدار میانگین آنها مشخص شود. سپس، میانگین مربع انحرافات باید محاسبه شود. بنابراین واریانس به عنوان معیاری برای برآورد کلی تغییرپذیری مورد نیاز است.
MARS
«MARS» سرنامی برای «Multivariate Adaptive Regression Splines» (رگرسیون چند متغیره اسپیلاین) و راهکاری برای عمومیساز ی درختهای تصمیم است.
بیشینه درستنمایی
روشهای دادهکاوی
تحلیلهای اکتشافی
به جستوجو در دادهها به منظور کشف ارتباطاتی که پیش از این شناخته نشدهاند «تحلیل اکتشافی» (Exploratory Analysis) گفته میشود. ابزارهای تحلیل اکتشافی اغلب به کاربر در ساخت جداول و نمایش گرافیکی کمک میکنند.
استنتاج
با «استنتاج کردن» (Deduction)، اطلاعاتی که دارای توالی منطقی در دادهها هستند حاصل میشوند.
استقرا
«استقرا» (Induction) روشی است که طی آن با استفاده از اطلاعات موجود در دادهها کلیت استنباط میشود.
استاندارد شده
مجموعهای از روشها که در آن تحلیلها از یک متغیر خوشتعریف (شناخته شده) وابسته استفاده میکنند را «استاندارد شده» (Standardize) گویند.
OLAP
ابزارهای «پردازش تحلیلی برخط» (Online Analytical Processing | OLAP) به کاربر قابلیت انجام تحلیلهای چند بُعدی دادهها را میدهد.
متغیر مستقل
«متغیر مستقل» (Independent Variable)، متغیری است که در معادله برای پیشبینی متغیر خروجی استفاده میشود.
متغیر وابسته
«متغیر وابسته» (Dependent Variable)، از جمله متغیرهای مدل است که باید توسط معادله مدل و با استفاده از متغیرهای مستقل پیشبینی شود.
یادگیری
آموزش مدلها (تخمین پارامترهای آنها)، بر پایه دادههای موجود را «یادگیری» (Learning) گویند.

یادگیری نظارت نشده
آموزش
«آموزش» (Training) اصطلاحی است که برای تخمین پارامترهای مدل بر پایه مجموعه داده موجود مورد استفاده قرار میگیرد.
دادههای آموزش
«داده آموزش» (Train Data)، یک مجموعه داده است که برای تخمین یا آموزش مدل مورد استفاده قرار میگیرد.
دادههای تست
یک مجموعه داده مستقل از دادههای آموزش که برای تنظیم تخمین پارامترهای مدل (مانند وزنها) مورد استفاد قرار میگیرد را «مجموعه داده تست» (Test Data Set) گویند. از مجموعه داده تست برای ارزیابی عملکرد مدلهای نظارت شده آموزش دیده نیز استفاده میشود.
درجه برازش
بیش برازش
وابستگی
تالی
پشتیبان
شیوع
«شیوع» (Prevalence) سنجهای است از اینکه چند وقت یک بار مجموعهای از اقلام در یک وابستگی به طور همزمان به وقوع میپیوندند.
Right-hand side
هنگامی که نیاز به تعریف وابستگی در میان دو متغیر باشد، آیتم دوم در «سمت راست» (Right-hand side) قرار دارد.
کشف توالی
همچون الگوریتم وابستگی، در «کشف توالی» (Sequence Discovery) نیز توالی سریهای زمانی وجود دارد. برای مثال، ۲۰ درصد از افرادی که VCR خریدهاند، یک دوربین ویدئویی نیز طی ۴ ماه خریداری کردهاند.
لایه
اساسا، گرهها در یک «شبکه عصبی» (Neural Networks) در «لایهها» (layers) گروهبندی میشوند. همچنین، هر لایه به عنوان ورودی، خروجی یا پنهان تعریف میشود. تعداد گرههای خروجی با متغیرهای خروجی برابر است. معمولا یک یا دو لایه پنهان در یک شبکه عصبی وجود دارد.

بازگشت به عقب
«بازگشت به عقب» (Backpropagation) نوعی از روشهای آموزش مدل است. از این روش برای محاسبه وزنها در «شبکه عصبی» (Neural Network) با استفاده از دادهها استفاده میشود.
پیشخور
توپولوژی
در یک شبکه عصبی، «توپولوژی» (Topology) به تعداد لایهها و تعداد گرههای هر لایه باز میگردد.
دستهبندی
«دستهبندی» (Classification)، روشی برای حل مسائل دادهکاوی است که طی آن دسته دادههای موجود، با ساخت یک مدل پیشبینی میشود. مدل مذکور برپایه تعدادی متغیر پیشبین ساخته میشود.
درخت تصمیم

درخت دستهبندی
درخت دستهبندی نوعی درخت تصمیم است که «متغیرهای دستهای» (Categorical Variables) را در کلاسها قرار میدهد.
درخت رگرسیون
CART
CHAID
«CHAID» سرنامی برای عبارت «Chi-squared Automatic Interaction Detector» (شناساگر تعامل خودکار خی دو) است. این الگوریتم برای برازش درختهای دستهای مورد استفاده قرار میگیرد و برای جداسازی دادهها در مجموعههای دادههای کوچک متصل بر آمارهای خی دو تکیه دارد.
برگ
گرهای در درخت رگرسیون یا دستهبندی که قابل تقسیم نیست را «برگ» (Leaf) گویند.
هرس کردن
حذف سطح پایینتر در درخت تصمیم را «هرس کردن» (Pruning) گویند. همچنین، از این اصطلاح برای تشریح الگوریتمها نیز استفاده میشود. زیرا میتوان از این اصطلاح برای تنظیم توپولوژی یک شبکه عصبی با حذف (هرس کردن) گرههای پنهان استفاده کرد.
گره
یک نقطه تصمیمگیری در یک درخت تصمیم را «گره» (Node) گویند. همچنین، یک نقطه در شبکه عصبی که نیاز به ترکیب ورودیها از دیگر گرهها دارد را گویند.
k-نزدیکترین همسایگی

الگوریتم ژنتیک
ارزیابی مدل
یک مدل دادهکاوی پس از نهایی شدن، باید از ابعاد گوناگون از جمله ارائه پاسخهای صحیح برای دادههای جدید و قابلیت تعمیم مورد بررسی قرار بگیرد و «ارزیابی» (Evaluation) شود.

اعتبارسنجی
فرآیند ارزیابی مدل با مجموعه داده متفاوت از مجموعه داده آموزش را «اعتبارسنجی» (Validation) گویند.
ماتریس درهمریختگی
اعتبارسنجی متقابل

معیارهای بهینهسازی
«معیار بهینهسازی» (ٰOptimization Criterion)، یک تابع مثبت از تفاوت بین پیشبینیها و تخمینهای دادهای است که انتخاب شدهاند، تا تابع یا ساخت را بهینهسازی کنند. کمترین مربعات و بیشینهسازی درستنمایی از جمله معیارهای بهینهسازی محسوب میشوند.
تحلیل تمایز
آنتروپی
«آنتروپی» (Entropy | بینظمی) روشی برای محاسبه بینظمی در دادهها است که بر مدل احتمالی تکیه دارد. برخی از درختهای تصمیم، دادهها را به گروههایی بر مبنای حداقل آنتروپی تقسیم میکنند.
R-squared
R-squared عددی است بین ۰ و ۱ که اندازهگیری میکند یک مدل چقدر خوب روی مجموعه دادههای آموزش برازش شده است. صفر حاکی از آن است که مدل هیچ توانایی پیشبینی ندارد. این روش «کوواریانس» (Covariance) بین مقادیر پیشبینی و مشاهده شده که توسط «انحراف معیار» مقادیر پیشبینی و مشاهده شده تقسیم شدهاند را محاسبه میکند.
سایر مفاهیم
دیگر مفاهیم مورد استفاده در این حوزه در ادامه بیان شدهاند.
منطق فازی
«منطق فازی» (Fuzzy Logic)، بر مجموعههای فازی اعمال شده است. عضویت در یک مجموعه فازی دارای درجهای است که الزاما ۰ یا ۱ نیست. منطق غیر فازی خروجیهایی را دستکاری میکند که درست یا غلط هستند. منطق فازی نیاز به دستکاری درجه «امکان» علاوه بر درست و غلط دارد.

نقشه ویژگی Kohonen
«نقشه ویژگی Kohonen» نوعی از شبکههای عصبی است که از یادگیری نظارت نشده برای یافتن الگوها در دادهها استفاده میکند. در دادهکاوی، از این روش برای تحلیل خوشه استفاده میشود.
دورافتادگی
دامنه
دامنه دادهها تفاوت بین مقدار بیشینه و مقدار کمینه است. به طور همزمان، یک دامنه میتواند شامل کمینه و بیشینه باشد.

تعامل
«تعامل» (Interaction) زمانی به وقوع میپیوندد که دو متغیر مستقل با یکدیگر تعامل داشته باشند. به عبارت دیگر هر گاه تغییر مقدار یک متغیر، اثر بر متغیر وابسته دیگری را تغییر دهد تعامل به وقوع پیوسته است.
خطای وضعیت مجدد
تخمین خطا بر پایه تفاوت بین مقادیر پیشبینی شده و مقادیر موجود در مجموعه داده آموزش را «خطای وضعیت مجدد» (Resubstitution Error) گویند.
نمونهبرداری

تحلیل حساسیت
تنوع پارامترهای یک مدل به منظور ارزیابی تغییرات در ورودی را «تحلیل حساسیت» (Sensitivity Analysis) گویند.
پردازش موازی
SMP
«SMP» سرنامی برای عبارت «Symmetric Multi-processing» (چند پردازشی متقارن) محسوب میشود و پیکربندی کامپیوتری است که در آن پردازندههای زیادی یک سیستمعامل واحد، حافظه اصلی و دیسک را با یکدیگر به اشتراک میگذراند. این پردازندهها میتوانند روی بخشهای گوناگون مساله به طور همزمان کار کنند.
خطای تست
تخمین خطا بر پایه مجموعه تفاوت بین پیشبینیهای مدل روی دادههای تست و مقادیر مشاهده شده در مجموعه دادههای تست هنگامی که دادههای تست برای آموزش مدل مورد استفاده قرار نگرفتهاند را «خطای تست» (Test Error) گویند.
سریهای زمانی
یک سری از مقادیر که در نقاط متوالی در زمان به وقوع پیوستهاند را «سری زمانی» (Time Series) گویند. سریهای زمانی نوعی داده محسوب میشوند.
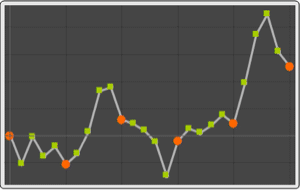
مدل سریهای زمانی
«مدل سریهای زمانی» (Time Series Model) نوعی مدل است که مقادیر آینده یک سری زمانی را بر اساس مقادیر پیشین محاسبه میکند.

پنجرهسازی
نتیجهگیری

اگر مطلب بالا برای شما مفید بوده، آموزشهای زیر نیز به شما پیشنهاد میشوند:
- مجموعه آموزشهای آمار، احتمالات و دادهکاوی
- مجموعه آموزشهای یادگیری ماشین و بازشناسی الگو
- مجموعه آموزشهای هوش محاسباتی
- مجموعه آموزشهای شبکههای عصبی مصنوعی
- گنجینه آموزشهای برنامه نویسی پایتون (Python)
- آموزش برنامهنویسی R و نرمافزار R Studio
- مجموعه آموزشهای برنامه نویسی متلب (MATLAB)
- علم داده، تحلیل داده، دادهکاوی و یادگیری ماشین ــ تفاوتها و شباهتها
- دوره آموزش یادگیری ماشین وبلاگ فرادرس با مثالهای کاربردی
^^
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید


سلام و خیلی ممنون از مطالب مفید ی که یه زبان ساده آموزش م ذهید من اطلاعاتی در باره مدل Dsmart میخواستم \یدا نکردم اگر راهنمایی بفرمایید ممنو می شومن