


کاهش زمان اجرا در رگرسیون بردار پشتیبان – پادکست پرسش و پاسخ


پادکست پیرامون روشهای کاهش زمان اجرا در رگرسیون بردار پشتیبان
نسخه نوشتاری
یکی از دوستان در مورد «رگرسیون بردار پشتیبان» سوال پرسیدند. این الگوریتم، یکی از انواع الگوریتمهای ماشینهای بردار پشتیبان است که برای حل مسائل رگرسیون و مدلسازی میتواند مورد استفاده قرار بگیرد. ایشان بررسی کردهاند و متوجه شدهاند که در حین اجرای برنامه، بیشترین زمانی که صرف میشود در بخش «Quadratic Programming» است و این بخش در کل بسیار زمانبر محسوب میشود. اکنون، این پرسش را مطرح کردهاند که «چطور میتوانند این مساله را حل کنند؟».
برای این مساله نمیتوان راه حل کلی ارائه کرد، اما چند راهکار برای آن وجود دارد که در ادامه شرح داده میشوند. راه اول این است که به همین شکل با موضوع کنار بیاییم و بپذیریم این مساله وجود دارد و بنابراین شکل مساله اصلی را تغییر ندهیم و خب از ابزار دیگری برای حال مساله استفاده کنیم. مثلا در حال حاضر پیکجهای مختلفی وجود دارند که از این جمله میتوان به پکیجهای موجود برای SVM در «متلب» (Matlab) اشاره کرد. LibSVM یکی از پکیجهای بیان شده است که در زبانهای برنامهنویسی C و ++C نوشته شده و نسبت به کد پیاده شده توسط کاربر در متلب، سرعت خیلی بیشتری دارد. این روش، یعنی استفاده از یک ابزار، یکی از راهکارهای موجود برای افزایش سرعت است.
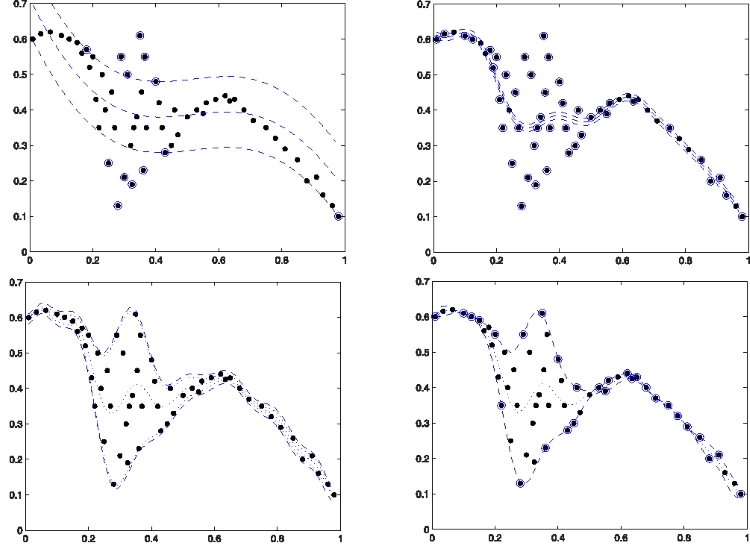
دوگان مساله «انتخاب ویژگی» (Feature Selection) آن بود که طی آن ویژگیهای مهم را انتخاب میکردیم. دوگان این میتواند انتخاب دادههای مهم و یا حذف دادههایی باشد که خیلی شبیه هم هستند و یا در واقع تنوع (Diversity) بالایی به مساله اضافه نمیکنند. دادهای که چند بار تکرار شده باشد در یک محدوده خیلی کم، همه اینها یک داده هستند و لازم نیست که ما به جای یک داده ده تا در نظر بگیریم. نه؛ میتوانید چند تا از این موارد را حذف کنید و در واقع اگر اشکالی به روند کلی حل مسئله وارد نمیشود آنها را به کنار بگذارید. در واقع، دادهها در گروههای مشابه قرار میگیرند و از بین اینها، مثلا از بین هر ده مورد، یکی انتخاب میشود.
البته باید به این نکته توجه داشت که دادههایی که در افزایش تنوع دادهای موثرتر هستند، اهمیت بیشتری دارند و معمولا دادههایی که در محلهای دورتر و در واقع خلوتتر قرار میگیرند مهمتر محسوب میشوند. مفهوم مشابهی نیز در بحث «خوشهبندی» (Clustering) وجود دارد. در واقع، در مساله خوشهبندی میتوان با تعداد خوشه بیشتر کار خوشهبندی را انجام داد. مثلا فرض کنید که حجم زیادی داده و برای مثال ده هزار داده دارید. این دادهها را میتوان به صد خوشه تبدیل کرد و صد مرکز خوشه به دست آورد. البته مثلا باید از روش «K-Medoids» استفاده کرد. از سوی دیگر، میتوان از صد خوشه به دست آمده، یکی از اعضای خوشه را انتخاب کرد و یا در صورتی که از الگوریتم K-Medoids استفاده شده، مرکز خوشهای را معرفی کرد که بهترین نمونه هم باشد.

اگر نوشته بالا برای شما مفید بوده است، مطالب زیر نیز به شما پیشنهاد میشوند:
- مجموعه آموزشهای دادهکاوی و یادگیری ماشین
- آموزش دادهکاوی یا Data Mining در متلب
- آموزش خوشهبندی با استفاده از الگوریتمهای تکاملی و فراابتکاری
- آموزش شبکههای عصبی مصنوعی در متلب
- انواع شبکههای عصبی و کاربردهای آنها — پادکست پرسش و پاسخ
^^
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید


سلام با توجه به اینکه svr نسبت به داده های پرت خیلی حساس است چگونه در متلب یا اپلیکیشن regression متلب می توان داده های پرت را محدود یا حذف یا حساسیت آن را تنظیم کرد ؟