



ساخت تابع پایتون برای پاکسازی داده ها – راهنمای کاربردی


ساخت تابع پایتون برای پاکسازی داده ها
توابعی برای مدیریت مقادیر ناموجود یا گمشده

اولین تابعی که در اینجا وجود دارد، برای دادن یک ایده کلی پیرامون تعداد کل و درصد دادهها در هر ستون است.
پس از وارسی اولیه، میتوان تصمیم گرفت که آیا نیاز است بررسی نزدیکتری روی ستونهای حاوی مقادیر از دست رفته انجام شود یا خیر. با تعیین آستانه برای درصد مقادیر ناموجود، تابعی که در ادامه میآید یک لیست از ستونهای حاوی مقادیر ناموجود را که تعداد مقادیر ناموجود آنها بیشتر از آستانه است، ارائه میکند.
راهکارهای زیادی برای مواجهه با این مقادیر ناموجود وجود دارد. اگر کاربر تصمیم بگیرد که ستونهای حاوی مقادیر ناموجود زیاد را حذف کند (فراتر از آستانهای که تعریف میکند)، میتواند از تابعی که در ادامه آمده است برای انجام این کار استفاده کند.
def drop_columns_w_many_nans(df, missing_percent):
    '''
    Takes df, missing percentage
    Drops the columns whose missing value is bigger than missing percentage
    Returns df
    '''
    series = view_columns_w_many_nans(df, missing_percent=missing_percent)
    list_of_cols = series.index.to_list()
    df.drop(columns=list_of_cols)
    print(list_of_cols)
    return df
اگرچه، نقاط ضعف زیادی متوجه حذف کامل مقادیر ناموجود از مجموعه داده است؛ از جمله این موارد میتوان به کاهش قدرت آماری اشاره کرد. اگر کاربر تصمیم بگیرد که مقادیر ناموجود را جایگزین کند، میتواند از راهکارهای گوناگون موجود برای این کار را استفاده و احتمال آسیب زدن به دادهها و خروجی نهایی را کاهش دهد.
توابع بصریسازی دادهها
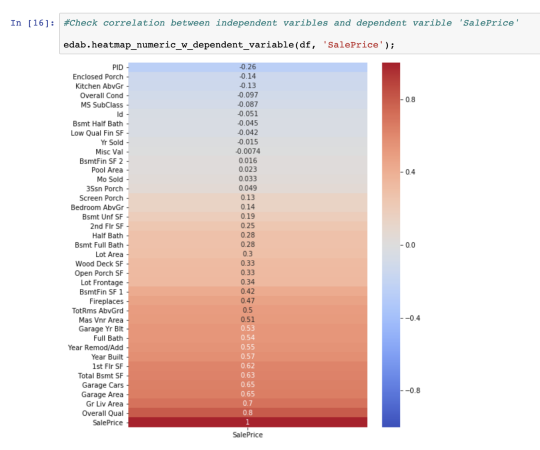
اگرچه، ساخت نمودارهای جدا برای هر متغیر، میتواند کاری خسته کننده باشد؛ به ویژه هنگامی که تعداد زیادی از ویژگیها وجود دارند. در این بخش، به بررسی توابعی برای ساخت یک گروه از نمودارها پرداخته میشود که میتوانند به کاربر برای زدن چند نشان با یک تیر، کمک بسیار زیادی کنند. در این راستا، معمولا نگاهی به توزیع ستونها با مقادیر عددی انداخته میشود. تابعی که در ادامه آمده است، یک گروه از نمودارها را برای همه ستونهای عددی در مجموعه داده میسازد.
خروجی کامل به صورت زیر خواهد بود.


توابعی برای تغییر انواع دادهها
خواندن دیکشنری دادهها میتواند در این راستا بسیار کمک کننده و شفاف کننده مسأله باشد. علاوه بر آن، اگر کاربر در صدد انجام مهندسی ویژگیها باشد، نیاز به تغییر انواع دادهها وجود دارد. دو تابع زیر، دست به دست هم برای تبدیل ویژگیهای دستهای به عددی (طبقهای) یاریگر هستند. اولین تابع، برای خروجی دادن یک تابع است؛ برای مثال، تبدیل کننده (Transformer) هر str در لیست را به یک int تبدیل میکند که در آن، int اندیس آن عنصر در لیست است.
دومین تابع، دارای دو بخش است. اولین بخش، یک دیکشنری به شکل زیر را دریافت میکند.
با استفاده از تابع قبلی که پیش از این تعریف شده است، دیکشنری به چیزی شبیه به زیر تبدیل میشود.
دومین بخش از این تابع از متد map(). برای نگاشت هر تابع مبدل به یک چارچوب داده (دیتافریم) استفاده میکند. شایان ذکر است که یک کپی از چارچوب داده اصلی، در طول این تابع ساخته میشود.

اگر نوشته بالا برای شما مفید بوده است، آموزشهای زیر نیز به شما پیشنهاد میشوند:
- مجموعه آموزشهای آمار، احتمالات و دادهکاوی
- آموزش هوش مصنوعی
- مجموعه آموزشهای برنامه نویسی پایتون (Python)
- داده کاوی (Data Mining) — از صفر تا صد
- یادگیری علم داده (Data Science) با پایتون — از صفر تا صد
- معرفی منابع جهت آموزش یادگیری عمیق (Deep Learning) — راهنمای کامل
^^
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید