

تفاوت طبقه بندی و خوشه بندی در یادگیری ماشین چیست؟ – ۳ فرق کلیدی
- خواهید آموخت که تفاوت بنیادین طبقهبندی و خوشهبندی چیست.
- میآموزید چگونه نوع داده در تعیین و انتخاب روش مناسب تأثیر دارد.
- یاد میگیرید که چه زمانی باید از الگوریتمهای مهم طبقهبندی استفاده کنید.
- خواهید توانست دادههای برچسبدار و بدون برچسب را تشخیص دهید.
- با ساختار و منطق اصلی الگوریتمهای خوشهبندی آشنا میشوید.
- یاد خواهید گرفت مزیتهای هر مدل را در پروژه بسنجید.


در این مطلب، ابتدا تعریفی از دو رویکرد طبقهبندی و خوشهبندی ارائه داده و به معرفی انواع الگوریتمهای رایج هر کدام میپردازیم. سپس یاد میگیریم تفاوت طبقه بندی و خوشه بندی در چیست و در نهایت نیز به چند مورد از سوالات متداول و مرتبط پاسخ میدهیم.
طبقه بندی چیست؟

- «پالایش اسپم» (Spam Filtering): طبقهبندی ایمیلهای مخرب و اسپم؛ در جهت جلوگیری از رسیدن چنین نمونههای بهدست کاربر.
- «بازشناسی چهره» (Face Recognition): شناسایی و تایید هویت افراد بر اساس ویژگیهای چهره در تصویر، ویدئو و یا بهصورت بلادرنگ و در لحظه.
- پیشبینی «ریزش مشتری» (Customer Churn): میتوان از طبقهبندی برای پیشبینی مشتریانی که احتمال دارد لغو عضویت کرده یا سرویس شما را ترک کنند بهره برد و با بهکارگیری راهکارهای جدید مانند کمپینهای تبلیغاتی، برای حفظ و ماندگاری آنها تلاش کرد.
- «پذیرش وام» (Loan Approval): تشخیص دادن واجد شرایط بودن یا نبودن یک مراجعهکننده برای دریافت وام، فرایندی تکراری و یکنواخت است. از همینرو، الگوریتمهای طبقهبندی با در نظر گرفتن معیارهایی همچون سابقه مالی فرد، پیشبینی میکنند که آیا وام به او تعلق میگیرد یا خیر.
انواع الگوریتم های طبقه بندی
در فهرست زیر، برخی از رایجترین و مورد استفادهترین الگوریتمهای طبقهبندی را ملاحظه میکنید:
- «رگرسیون لجستیک» (Logistic Regression)
- «K-نزدیکترین همسایه» (K-Nearest Neighbors | KNN)
- «درخت تصمیم» (Decision Tree)
- «جنگل تصادفی» (Random Forest)
- «بیز ساده» (Naive Bayes)
نحوه کارکرد هر کدام از الگوریتمهای عنوان شده متفاوت است و در ادامه بیشتر با هر کدام آشنا میشویم.

الگوریتم رگرسیون لجستیک


الگوریتم K-نزدیکترین همسایه

الگوریتم درخت تصمیم

الگوریتم جنگل تصادفی
الگوریتم «جنگل تصادفی» (Random Forest)، در واقع مدلی ترکیبی است که از یک یا چند درخت تصمیم تشکیل شده است. این تکنیک از روشهایی همچون «تجمیع بوتاسترپ» (Bootstrap Aggregation) و «زیرفضای تصادفی» (Random Subspace) برای بسط دادن درختها و دستیابی به یک مدل تجمعی که قادر به حل مسائل طبقهبندی و رگرسیون باشد، استفاده میکند. توجه داشته باشید که روشهای Bootstrap و Bagging، تکنیکهایی هستند که از نسخههای مختلف یک مدل، در ساخت مدلی تجمعی بهره میبرند. با کاهش همبستگی میان مدلهای پیشبینی کننده، عملکرد مدل تجمعی نسبت به نمونههای جدید بهبود مییابد. در این الگوریتم، ابتدا بهصورت تصادفی از دادههای هر مدل نمونهگیری شده و سپس از آنها در فرایند آموزش استفاده میشود.

روش زیرفضای تصادفی وظیفه کاهش همبستگی میان چند مدل را در «یادگیری جمعی» (Ensemble Learning) بر عهده دارد.
الگوریتم بیز ساده
خوشه بندی چیست؟


برخلاف یادگیری نظارت شده، در یادگیری نظارت نشده برای گروهبندی و پیدا کردن الگوهای داده، نیازی به برچسب نیست. بلکه اینطور در نظر گرفته میشود که نمونههای همگروه، ویژگیهای مشابهی نیز دارند. از همین جهت، خوشهبندی نوعی تکنیک یادگیری نظارت نشده است که دادههای بدون برچسب را بر اساس شباهتها و تفاوتهایشان گروهبندی میکند. از جمله کاربردهای خوشهبندی میتوان به موارد زیر اشاره کرد:
- «بخشبندی بازار» (Market Segmentation): بهطور معمول، تیمهای بازاریابی علاقه دارند تا خریداران احتمالی را بر اساس نیازهای مشترک در گروههای مختلف طبقهبندی کنند. به این شکل و با درک ویژگیهای مشترک، کسبوکارها محصولات خود را در راستای نیاز مشتری قرار داده و برنامهریزی دقیقتری ارائه میدهند.
- «تحلیل شبکههای اجتماعی» (Social Network Analysis): کسبوکارها با پیادهسازی الگوریتمهای خوشهبندی بر روی دادههای حاصل از شبکههای اجتماعی، اهداف و تصمیمات تجاری آینده خود را شناسایی میکنند.
- «بخشبندی تصاویر» (Image Segmentation): بخشبندی تصاویر دیجیتال، با هدف سادهسازی و راحتتر شدن فرایند تجزیه و تحلیل انجام میشود.
- «موتورهای توصیهگر» (Recommendation Engines): الگوریتمهای خوشهبندی ارتباط میان رفتار گذشته کاربر را با گرایشهای نو پیدا کرده و به استراتژیهای فروش بهینهتری منجر میشوند.
چگونه فرق خوشه بندی و طبقه بندی را یاد بگیریم؟

برای شروع، ابتدا باید تفاوت اساسی بین طبقهبندی و خوشهبندی در یادگیری ماشین را درک کنید. در طبقهبندی، هدف تخمین کلاس یا برچسب دستهای برای یک نمونه داده است، در حالی که در خوشهبندی، دادهها به گروههای مشابه بدون اطلاع از برچسبها تقسیم میشوند. پس از درک تفاوتها، به مفاهیم پایه یادگیری ماشین بپردازید. از جمله این موارد میتوان به درخت تصمیم و الگوریتمهای خوشهبندی مانند K-Means اشاره کرد.. سپس، با مطالعه موارد کاربردی هر روش در مسائل واقعی، آشنایی بیشتری با آنها پیدا کنید.
در مرحله بعدی، با مطالعه مفاهیم پیشرفتهتر و الگوریتمهای متنوعتر در هر دو حوزه، مانند روشهای تقویت شده طبقهبندی یا الگوریتمهای خوشهبندی سلسلهمراتبی، توانمندیهای بیشتر ماشین یادگیری را یاد بگیرید. در نهایت، با استفاده از فیلمهای آموزشی مرتبط با یادگیری ماشین در فرادرس، میتوانید مفاهیم را به طور کامل درک کنید و به کاربردهای عملی آنها در زمینههای مختلف پی ببرید.
میتوانید فیلم های آموزشی مرتبط با طبقهبندی و خوشهبندی در یادگیری ماشین را از لینکهای زیر در فرادرس بررسی کنید.
- آموزش یادگیری ماشین
- آموزش کاربردی شبکه های عصبی مصنوعی – طبقه بندی، پیش بینی و ترکیب با الگوریتم های تکاملی
- آموزش طبقه بندی و بازشناسی الگو با شبکه های عصبی LVQ در متلب MATLAB
- آموزش تخمین خطای طبقه بندی یا کلاسیفایر در داده کاوی
- آموزش خوشه بندی با الگوریتم های تکاملی و فراابتکاری
- آموزش خوشه بندی سلسله مراتبی در آر R
- آموزش خوشه بندی K میانگین K-Means با اس پی اس اس SPSS
- آموزش داده کاوی Data Mining در متلب MATLAB
انواع الگوریتم های خوشه بندی
پس از معرفی الگوریتمهای طبقهبندی و پیش از آنکه به تفاوت طبقه بندی و خوشه بندی بپردازیم، بهتر است ابتدا با انواع الگوریتمهای خوشهبندی نیز آشنا شویم. در این بخش، به بررسی چند مورد از کاربردیترین الگوریتمهای خوشهبندی میپردازیم.
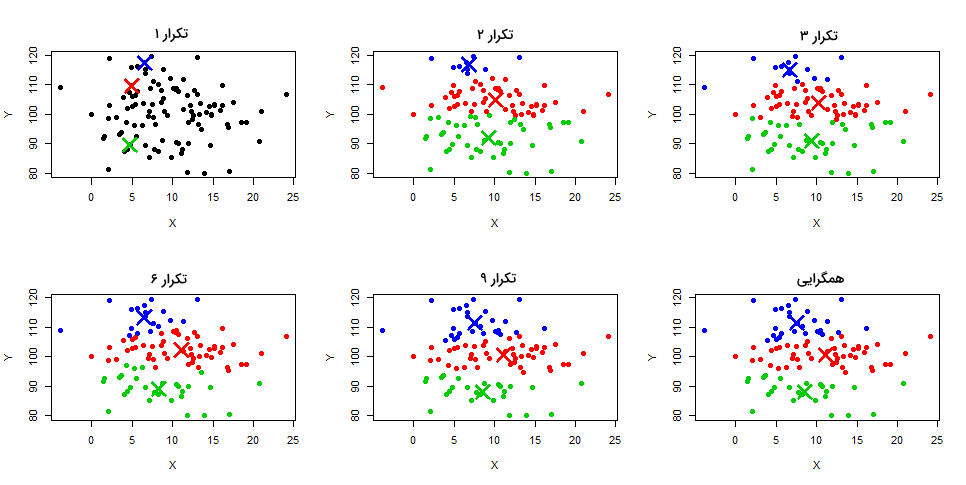
الگوریتم خوشه بندی K میانگین
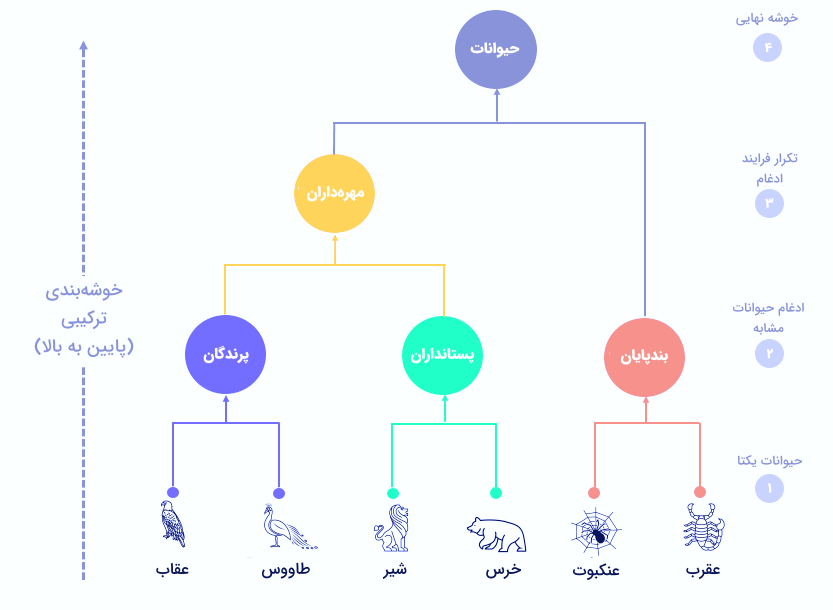
الگوریتم خوشه بندی سلسله مراتبی
روش ترکیبی
رویکردی پایین به بالا که در مرحله شروع، هر نمونه به عنوان یک خوشه مجزا در نظر گرفته میشود. همزمان با تکمیل شدن ساختار سلسله مراتبی از پایین به بالا، نمونهها با یکدیگر ادغام شده و در نهایت، جفت نمونهها به یک خوشه تبدیل میشوند.
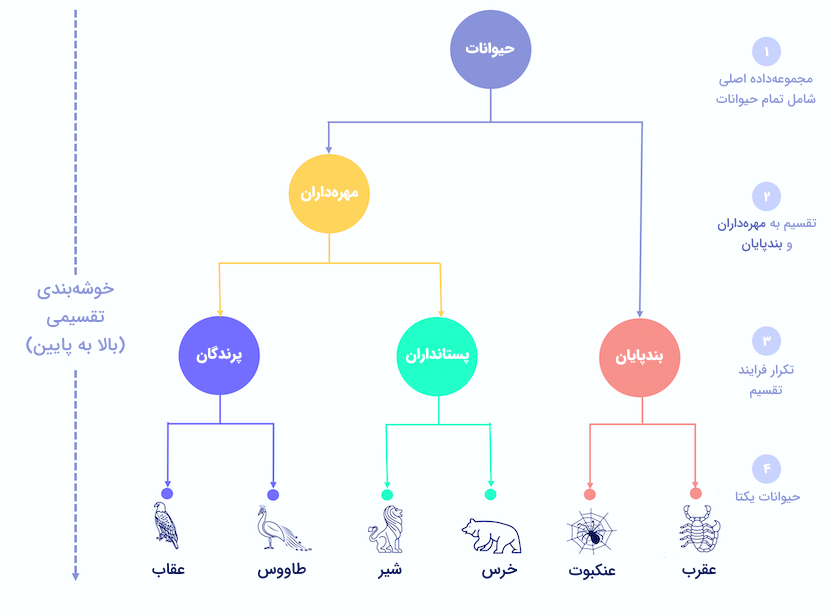
روش تقسیمی
خوشهبندی تقسیمی، نوعی روش بالا به پایین است که ابتدا تمامی نمونهها در یک خوشه قرار دارند و سپس در هر مرحله بهصورت بازگشتی، خوشهها تقسیم شده و ساختار سلسله مراتبی از بالا به پایین شکل میگیرد.
الگوریتم DBSCAN

الگوریتم OPTICS
نام الگوریتم OPTICS مخفف عبارت (Ordering Points to Identify the Clustering Structure) به معنی مرتبسازی نقاط داده برای شناسایی ساختار خوشهبندی است. مانند DBSCAN، روش OPTICS نیز الگوریتمی مبتنیبر چگالی است که توسط همان تیم تحقیقاتی توسعه داده شده است. هدف الگوریتم OPTICS، برطرف کردن مهمترین چالش DBSCAN، یعنی شناسایی خوشهها صرفنظر از میزان تراکم و فرضیه ثابت بودن چگالی دادهها میباشد.
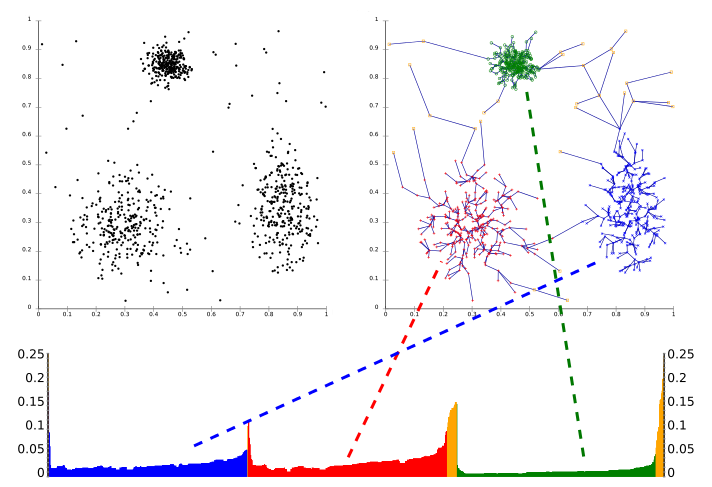
توجه داشته باشید که «نمودار دسترسپذیری» (Reachability Plot) در تصویر بالا نشانگر فاصله هر نمونه تا مرکز خوشه است.
تفاوت طبقه بندی و خوشه بندی
بررسی تفاوت طبقه بندی و خوشه بندی نیازمند آشنایی و بهدست آوردن درک اولیه از انواع الگوریتمهای این دو روش است که در بخشهای قبلی این مطلب به آنها پرداختیم. در ادامه، به شرح تفاوت طبقه بندی و خوشه بندی از سه جنبه مهم میپردازیم.
۱. یادگیری نظارت شده و نظارت نشده
طبقهبندی، نوعی روش یادگیری نظارت شده است. یادگیری نظارت شده شامل یادگیری تابعی است که بر اساس آموختههای قبلی، یک ورودی را به خروجی متناظر نگاشت میکند. در مقابل، یادگیری نظارت نشده از تکنیکهایی همچون خوشهبندی، برای کشف الگوهای پنهان در دادههای بدون برچسب بهره میبرد.
۲. نیاز به داده های آموزشی و آزمایشی
هم طبقهبندی و هم خوشهبندی برای یادگیری روابط میان دادهها به مجموعه آموزشی نیاز دارند. با این حال، بهتر است برای ارزیابی عملکرد مدل یادگیری ماشین در مسائل طبقهبندی، از مجموعهداده آزمایشی نیز استفاده شود.

۳. تفاوت های الگوریتمی
الگوریتمهای خوشهبندی برای بهدست آوردن اطلاعات، به دادههای ورودی مدل یادگیری ماشین وابسته هستند. به بیان سادهتر، معلمی وجود ندارد که پاسخهای درست را به الگوریتم برساند؛ بلکه یادگیری توسط الگوریتم صورت میگیرد. اما الگوریتمهای طبقهبندی برای بهدست آوردن مدل یادگیری و در ادامه پیشبینی خروجی نمونههای جدید، به جفت دادههای ورودی و خروجی نیاز دارند. در جدول زیر، خلاصهای از تفاوت طبقه بندی و خوشه بندی را مشاهده میکنید:
| طبقهبندی | خوشهبندی | |
| نوع یادگیری | نظارت شده | نظارت نشده |
| نوع دادهها | برچسبگذاری شده | بدون برچسب |
| هدف | تخمین تابعی که با یادگیری مجموعهای از ورودیها با خروجی گسسته، در پیشبینی خروجی نمونههای جدید مورد استفاده قرار میگیرد. | یادگیری الگوهای پنهان ورودی، بهمنظور گروهبندی دادههای مختلف. |
| الگوریتمها | رگرسیون لجستیک، KNN، درخت تصمیم، جنگل تصادفی، بیز ساده | K-Means، خوشهبندی ترکیبی، خوشهبندی تقسیمی، DBSCAN، OPTICS |
| کاربردها | پیشبینی نرخ ریزش مشتری، پذیرش وام، پالایش اسپم، تشخیص چهره | بخشبندی بازار، بخشبندی تصاویر، تحلیل شبکههای اجتماعی، موتورهای توصیهگر |
سوالات متداول پیرامون تفاوت طبقه بندی و خوشه بندی
پس از آشنایی با انواع الگوریتمها و تفاوت طبقه بندی و خوشه بندی، حال زمان خوبی است تا در این بخش، به چند مورد از پرسشهای متداول در این زمینه پاسخ دهیم.

چه زمان باید به جای خوشه بندی از طبقه بندی استفاده شود؟
از طبقهبندی زمانی استفاده میشود که گروه یا کلاسهایی برای دستهبندی دادهها از پیش تعریف شده باشند. این در حالی است که هدف خوشهبندی در شناسایی الگو یا گروهبندی دادهها خلاصه میشود.
کدام یک در تحلیل داده دقیق تر عمل می کند؛ طبقه بندی یا خوشه بندی؟
بهطور پیشفرض، هیچکدام از این دو روش از دیگری دقیقتر نبوده و انتخاب تکنیک مناسب، به نوع مسئله و مجموعهداده بستگی دارد. همچنین کیفیت دادهها، نقش مهمی در دقت نتایج نهایی ایفا میکند.
در چه مسائلی از الگوریتم های طبقه بندی و خوشه بندی استفاده میشود؟
بخشبندی مشتریان، بازشناسی تصویر، تشخیص کلاهبرداری و طبقهبندی متن، از جمله رایجترین کاربردهای الگوریتمهای طبقهبندی و خوشهبندی به حساب میآیند.
جمعبندی
با وجود یکسان بودن هدف نهایی، دو رویکرد طبقهبندی و خوشهبندی روش منحصربهفرد خود را برای جداسازی نمونه دادهها در گروههای مجزا دارند. همانطور که در این مطلب از مجله فرادرس خواندیم، الگوریتمهای طبقهبندی برای مورد استفاده قرار گرفتن در کاربردهایی همچون پالایش ایمیلهای اسپم و پیشبینی نرخ ریزش مشتری، به دادههای برچسبگذاری شده نیاز دارند. از طرفی دیگر، خوشهبندی نیازی به چنین راهنماییهایی نداشته و به شیوهای اکتشافی، کاربرد خود را در مسائلی مانند بخشبندی بازار یا سیستمهای توصیهگر پیدا میکند. داشتن درکی مناسب از تفاوت طبقه بندی و خوشه بندی، تاثیر بهسزایی بر کارآمدی پروژههای یادگیری شما خواهد گذاشت.
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید