

استنباط آماری | مفاهیم اولیه و روشها – به زبان ساده
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید


استنباط آماری
علم آمار را علم جمعآوری، خلاصهسازی و سازماندهی و همچنین تجزیه و تحلیل داده میشناسند. آمار را باید علم استخراج، توسعه علوم و دانش تجربی انسان در نظر گرفت که برای بیان پدیدههای تصادفی (که اغلب نیز چنین است) با استفاده از روشهای گردآوری، تنظیم، پرورش و تحلیل دادههایی به کار میرود که از طریق روشهای اندازهگیری و آزمایشگاهی بدست آمدهاند.
«استنباط آماری» (Inferential statistics) شاخهای از علم آمار است که در این متن جنبههای مختلف و تکنیکهای آن را معرفی خواهیم کرد.
روش های استنباط آماری
از جنبه دیگر یکی از بخشهای مهم در آماری، قبل از اجرای استنباط آماری، جمعآوری دادهها است که بحث نمونهگیری مربوط میشود. موضوعاتی مانند خطای نمونهگیری و تعیین حجم نمونه یا «شیوه نمونهگیری» (Sampling) از مواردی است که در این بحث مطرح میشود.
روشهای پارامتری
در ادامه به چند روش آماری که به عنوان روشهای پارامتری شناخته میشوند، اشاره خواهیم کرد.
آزمون فرض آماری پارامتری
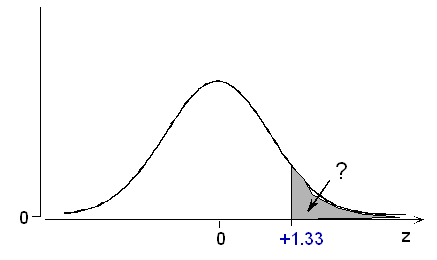
یکی از روشهای مطرح در استنباط آماری، آزمون فرض آماری است. در این تکنیک براساس گزارههایی که به صورت اطلاع از پارامتر جامعه یا توزیع آن نوشته میشوند، دو فرضیه میسازیم. «فرض صفر» (Null Hypothesis) و «فرض مقابل» (Alternative Hypothesis) این دو گزاره هستند.
نمونهای از فرضیات آزمون فرض آماری

فرض صفر، معمولا به گزاره یا خبری در مورد پارامتر اشاره دارد که در قبل از تحقیق آماری وجود داشته است. برای مثال میتوانیم در مورد میانگین جامعه آماری از گزاره زیر استفاده کنیم. این خبر براساس اطلاعات قدیمی و نحوه رشد دانش آموزان تهیه شده است:
«میانگین وزن دانش آموزان (جامعه آماری) برابر با ۵۳ کیلوگرم است.»
«میانگین وزن دانش آموزان (جامعه آماری) بیشتر از ۵۳ است.»
هر دو این گزارهها، خبری را در مورد پارامتر جامعه (میانگین) ارائه کردهاند. یکی مقدار آن را دقیقا مشخص کرده و دیگری کرانی برایش در نظر گرفته است. هدف محقق آن است که به واسطه نمونهای که تهیه کرده است (با شرط انصاف) بتواند فرض صفر را رد کرده و نشان دهد که میانگین وزن، افزایش داشته است. در حقیقت، نمونه آماری، در اینجا نقش یک مثال نقض را دارد. اگر گزاره اول (فرض صفر) توسط نمونه رد شود، یک مثال نقض در رد آن ارائه شده و با کمی احتیاط، ممکن است نتیجه بگیریم که گزاره مربوط به فرض مقابل تایید میشود.
اگر فرض صفر را به اشتباه رد کرده باشیم، دچار خطای نوع اول شدهایم. به تفسیر دیگر میگوییم خطای نوع اول، رد فرض صفر به ناحق است. احتمال رخداد چنین پیشامدی را با نشان میدهند. باید آزمونها و ناحیه بحرانی را به شکلی برای آزمون بسازیم که میزان احتمال خطای نوع اول آن، کمینه باشد.
از طرفی خطای نوع دوم نیز به شکل رد فرض مقابل به اشتباه محسوب میشود. احتمال رخداد چنین پیشامدی نیز با نمایش داده میشود. همچنین توجه داشته باشید که توان آزمون به معنی رد فرض صفر (یا تایید فرض مقابل) به درستی است که در این حالت به شکل محاسبه میشود.
فاصله اطمینان پارامتری

ولی اگر بخواهیم برای پارامتر، یک بازه تصادفی با درجه اطمینان معین ایجاد کنیم، فاصله اطمینان (Confidence Interval) راهحل مناسب خواهد بود. یک فاصله اطمینان به اندازه به صورت زیر نوشته میشود.
نکته: معمولا اختلاف در و در ضرایب یا مقادیر ثابت است که جنبه تصادفی ندارند. بنابراین میتوان بخش تصادفی هر دو کران را با یک توزیع تعیین کرد و در اغلب موارد احتیاجی به توزیع توام نیست.
روشهای ناپارامتری
اگر از دنیای ایدهآل و آرمانی در آمار خارج شویم در اکثر مواقع امکان استفاده از قضیه حد مرکزی وجود ندارد. بنابراین فرض نرمال بودن و استفاده از توزیعهای مطرح آماری میسر نخواهد بود. در این حالت بدون توجه به توزیع جامعه آماری و به صرف بررسی «آمارههای ترتیبی» (Ordered Statistics) یا «آمارههای مبتنی بر شمارش» (Counting Statistics)، باید دست به قضاوت زده و استنباط آماری را اجرا کنیم. در این حالت تکنیکهای آماری را «ناپارامتری» (Non-parametric Method) یا «آزاد-توزیع» (Distribution- Free) مینامند.
نمونهای از یک آماره ترتیبی
آزمون فرض آماری ناپارامتری
در روشها یا تکنیکهای آمار ناپارامتری، فرض صفر و مقابل درست به مانند صورتهای پارامتری نوشته و تفسیر میشوند. خطای نوع اول و دوم نیز در اینجا مطرح است. ولی در اغلب موارد شکل توزیع آماره آزمون به سختی قابل محاسبه است. همانطور که گفته شد، در بیشتر موارد از شبیهسازی استفاده کرده و توزیع حاصل را در جدولهایی خلاصه میکنند.
این جدولها مبنایی برای اجرای آزمونهای ناپارامتری هستند. به این ترتیب برای هر یک از آزمونهای ناپارامتری، جدولی برای تعیین اندازه آزمون () و ناحیه بحرانی وجود دارد.
نکته: یکی از مواردی که باید از روشهای ناپارامتری استفاده کرد، کم بودن اندازه یا حجم نمونه است. در این موارد امکان به کارگیری قضیه حد مرکزی وجود ندارد.

فاصله اطمینان ناپارامتری
همانطور که گفته شد، توزیع آمارههای ناپارمتری، پیچیده است. به همین دلیل از روشهای دیگر مانند استفاده از تکنیکهای بازنمونهگیری برای تعیین میانگین یا واریانس (پراکندگی) آنها استفاده میکنند. به این ترتیب فاصله اطمینان حاصل نیز براساس این دو مشخصه و چندکهای توزیع که از طریق شبیهسازی بدست میآیند، ساخته میشود.
برآورد خطا بوسیله روشهای بوت استرپ یا جک نایف
اهمیت این دو روش در زمانی مشخص میشود که امکان محاسبه خطای برآوردگر پارامتر موجود نباشد. برای مثال در بیشتر مواقع محاسبه خطای برآوردگر برای پارامترهایی مانند صدکهای جامعه آماری به راحتی امکان پذیر نیست.

در روش جک نایف برای n مشاهده، n زیرنمونه به اندازه n-1 مشاهده به کار رفته و برای برآورد پارامتر جامعه آماری، برآوردگر محاسبه میشود. البته در هر بار نمونهگیری، دقیقا یکی از مشاهدات کنار گذاشته میشود. به این ترتیب نمیتوان آن را یک نمونهگیری با جایگذاری در نظر گرفت.
از طرفی در روش بوت استرپ، زیرنمونهها، بوسیله نمونهگیری با جایگذاری از نمونه اصلی تولید میشوند. با توجه به اینکه تعداد نمونه اصلی برابر با n است، میتوان بینهایت بار عمل زیرنمونهگیری با اندازه n را اجرا کرد.
میانگین مقادیر یافت شده برای برآوردگر، مقدار پیشبینی شده برای پارامتر در نظر گرفته شده و واریانس آنها نیز، واریانس یا خطای برآوردگر را مشخص میکند. به این ترتیب واریانس و میانگین برآوردگر بدست آمده و فاصله اطمینان را میتوان به شکلی تعیین کرد که مقدار احتمال برای کرانهای پایین و بالا (مطابق با رابطه ۱) برابر با باشد.
رگرسیون و مدل سازی در آمار

خلاصه و جمعبندی
در این متن به بررسی جنبههای مختلف استنباط آماری یا آمار استنباطی پرداختیم و با بعضی از مفاهیم اولیه آن آشنا شدیم. همانطور که در متن خواندید، تعمیم ویژگیهای کشف شده از نمونه به جامعه آماری از کارهای اصلی در استنباط آماری است. همچنین نحوه نمونهگیری و آزمون فرض نیز از قسمتهای اصلی علم آمار محسوب شده که در استنباط آماری کاربرد زیادی دارند. فاصله اطمینان و انواع آن نیز جنبه دیگری از استنباط آماری محسوب میشود.
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید