



دسته بندی داده ها با پایتون – راهنمای کاربردی


هدف از این مطلب، شناسایی الگوریتم یادگیری ماشینی است که برای چنین مسالهای بالاترین صحت را ارائه میکند. بنابراین، الگوریتمهای گوناگون در ادامه با یکدیگر مقایسه میشوند و الگوریتمی با بهترین عملکرد، انتخاب میشود. با مطالعه این مطلب، میتوان با روشهای گوناگون دسته بندی داده ها با پایتون آشنا شد.
داده
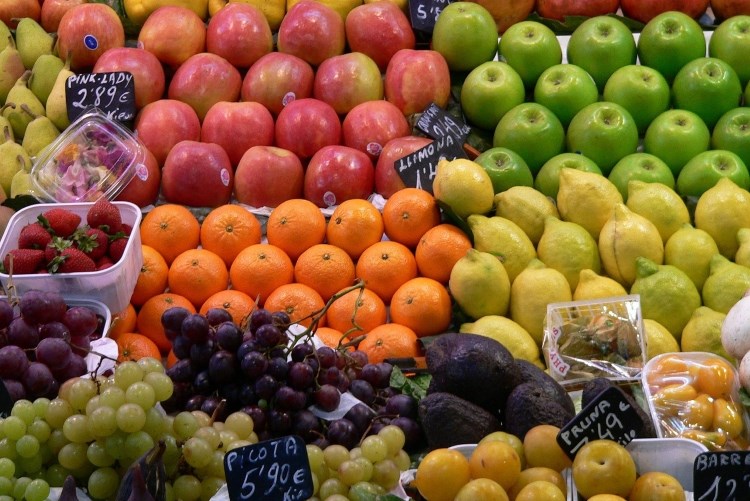
مجموعه داده میوهها، توسط دکتر «لاین مورای» (Iain Murray) از «دانشگاه اِدینبرا» (University of Edinburgh) ساخته شده است. وی، مقادیر زیادی پرتقال، لیمو و سیب از گونههای گوناگون را تهیه و اندازههای آنها را در یک جدول ثبت کرده است.
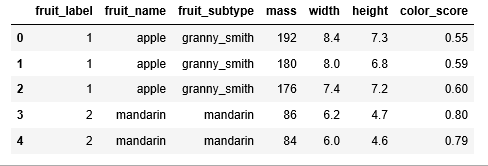
ورودی:
خروجی:
(59, 7)
چهار نوع میوه، در مجموعه داده وجود دارد (در واقع، با توجه به برچسبدار بودن مجموعه داده، چهار برچسب وجود دارد).
ورودی:
خروجی:
[‘apple’ ‘mandarin’ ‘orange’ ‘lemon’]
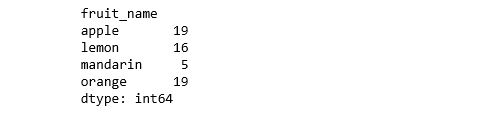
دادهها به جز در مورد «پرتقال ماندارین» (Mandarin)، متوازن هستند (که البته میتوان با این مساله کنار آمد).
ورودی:
خروجی:
خروجی:

بصریسازی
ورودی:
خروجی:
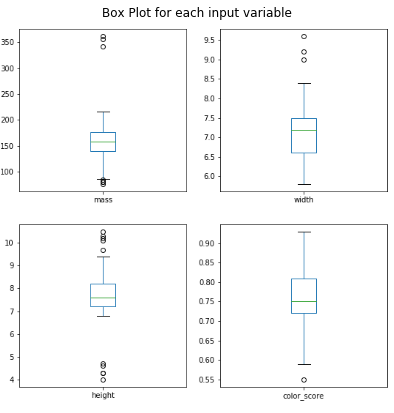
ورودی:
خروجی:

برخی از جفت ویژگیها، همبسته هستند (جرم و عرض). این امر موجب همبستگی بالا و رابطه قابل پیشبینی میشود.
ورودی:
خروجی:

خلاصه آماری

ساخت مجموعههای آموزش، تست و اعمال استانداردسازی
دسته بندی داده ها با پایتون
همانطور که پیشتر بیان شد، چندین مدل گوناگون روی مجموعه داده اعمال میشوند تا کارایی آنها سنجیده و صحت خروجی حاصل از هر یک از آنها، با دیگر الگوریتمها مقایسه شود. در نهایت، مدل با بهترین خروجی، انتخاب خواهد شد.
رگرسیون لجستیک
- صحت دستهبند رگرسیون لجستیک روی مجموعه داده آموزش: ۰.۷۰
- صحت دستهبند رگرسیون لجستیک روی مجموعه داده تست: ۰.۴۰
درخت تصمیم
- صحت دستهبند درخت تصمیم روی مجموعه داده آموزش: 1.00
- صحت دستهبند درخت تصمیم، روی مجموعه داده تست: ۰.۷۳
K-نزدیکترین همسایگی
- صحت دستهبندی KNN روی مجموعه داده آموزش: ۰.۹۵
- صحت دستهبندی KNN روی مجموعه تست: ۱.۰
آنالیز تشخیصی خطی
در ادامه، الگوریتم LDA روی مجموعه داده میوه اعمال شده است.
- صحت دستهبندی LDA روی مجموعه داده آموزش: ۰.۸۶
- صحت دستهبندی LDA روی مجموعه داده تست: ۰.۶۷
نایو بیز گاوسی
- صحت دستهبند نایو بیز گاوسی روی مجموعه آموزش: ۰.۸۶
- صحت دستهبند نایو بیز گاوسی روی مجموعه تست: ۰.۶۷
ماشین بردار پشتیبان
در ادامه، پیادهسازی SVM با استفاده از کتابخانه سایکیتلرن انجام شده است.
- صحت دستهبند ماشین بردار پشتیبانی روی مجموعه آموزش: ۰.۶۱
- صحت دستهبند ماشین بردار پشتیبان روی مجموعه تست: ۰.۳۳
نتیجهگیری

ترسیم مرزهای دستهبندی برای دستهبند K-نزدیکترین همسایگی


برای این مجموعه داده، بالاترین صحت هنگامی حاصل میشود که مقدار K در الگوریتم KNN برابر با پنج (k=5) تعیین شده است.
خلاصه

اگر مطلب بالا برای شما مفید بوده، آموزشهای زیر نیز به شما پیشنهاد میشود:
- مجموعه آموزشهای دادهکاوی و یادگیری ماشین
- مجموعه آموزشهای دادهکاوی یا Data Mining در متلب
- مجموعه آموزشهای هوش مصنوعی
- زبان برنامهنویسی پایتون (Python) — از صفر تا صد
- یادگیری ماشین با پایتون — به زبان ساده
- آموزش یادگیری ماشین با مثالهای کاربردی — مجموعه مقالات جامع وبلاگ فرادرس
- چگونه یک دانشمند داده شوید؟ — راهنمای گامبهگام به همراه معرفی منابع
^^
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید

خیلی ب دردم خورد دمتون گرم