


آزمون رگرسیون خطی در SPSS – راهنمای کاربردی
رگرسیون یا به اصطلاح «معادله خط برگشت» (Regression Line Equation) یک تکنیک آماری است که در بسیاری از حوزههای علمی، بخصوص «یادگیری ماشین» (Machine Learning) و «دادهکاوی» (Data Mining) کاربرد دارد. از آنجا که محاسبات برای اجرای رگرسیون خطی، زمانبر و طولانی است و باید دقیق باشد، در اغلب موارد از نرمافزارهای محاسبات آماری مانند SPSS برای انجام این کار استفاده میکنند. به همین دلیل نیز در این نوشتار به تکنیک و آزمون رگرسیون خطی در SPSS پرداخته و با ذکر مثالی، مراحل انجام این کار را مرور خواهیم کرد.


آزمون رگرسیون خطی ساده در SPSS
این خط میتوان بیانگر رابطه خطی بین «متغیرهای پاسخ» (Response Variable) و «متغیرهای توصیفی» (Exploratory Variables) باشد. شایان ذکر است که گاهی به متغیرهای پاسخ، «متغیرهای وابسته» (Dependent Variable) و به متغیرهای توصیفی نیز «متغیرهای مستقل» (Independent Variable) یا متغیرهای پیشگو میگویند.
در رابطه بالا، را «عرض از مبدا» (Intercept) و را «شیب خط» (Slop) میگویند. بنابراین در مدل رگرسیونی، هدف برآورد این دو پارامتر است. از آنجایی که دادههای جمعآوری شده، به صورت زوج مرتب هستند، آنها را به شکل نشان میدهیم. در حالت کلی رابطهای که بین نقطههای نمونه حاصل از جامعه آماری در رگرسیون خطی ساده در نظر گرفته میشود به صورت زیر است.
جمله یا عبارت ، عبارت خطا نامیده شده و ماهیت تصادفی بودن دادهها را نشان میدهد. یکی از شرطهای مهم در معادله رگرسیونی، آن است که میانگین خطا باید برابر با صفر باشد. به این ترتیب نشان میدهیم که انتظار داریم خطاهای با مقدار مثبت و خطایهای با مقدار منفی برای نقطههای پیشبینی شده، در مجموع یکدیگر را خنثی کنند.
- بررسی نرمال بودن باقیماندهها
- تصادفی بودن باقیماندهها
- ثابت بودن واریانس
- استقلال متغیرهای توصیفی (مستقل)
البته از آنجایی که در مدل و آزمون رگرسیون خطی فقط از یک متغیر مستقل استفاده میکنیم، شرط استقلال موردی نخواهد داشت.
اجرای مدل و آزمون رگرسیون خطی در SPSS
ابتدا به اطلاعاتی که در این فایل ثبت شده نگاهی میاندازیم. همانطور که در تصویر ۱ مشاهده میکنید، این مجموعه داده مربوط به ده کارمند است که اسامی آنها در ستون fname نوشته شده است. همچنین «ضریب هوش» (iq) که یک متغیر کمی است، به همراه «کارایی» (performance) نیز در این فایل اطلاعاتی ثبت شده است. به نظر میرسد که کارایی افراد باید با ضریب هوشی آنها در رابطه باشد. به این معنی که هر چه ضریب هوشی بیشتر باشد، کارایی نیز بیشتر خواهد بود. پس انتظار داریم رابطه بین این دو متغیر از نوع مستقیم باشد.
پس فرض میکنیم که میتوانیم براساس «ضریب هوش» (iq)، قادر به پیشگویی «کارایی» (performance) کارکنان باشیم. این امر میتواند ما را در استخدام کارمندان جدید یاری رساند. به این ترتیب قبل از استخدام، با اندازهگیری ضریب هوشی افراد این امکان را داریم که میزان کارایی آنها را در شرکت پیشبینی کنیم و بهترین فرد یا افراد را به استخدام درآوریم.


همانطور که در تصویر ۱ مشاهده میشود، متغیرهای مورد استفاده در مدل رگرسیونی، iq با برچسب IQ test score و Performance با برچسب Job performace test score هستند. این دو متغیر از نوع Scale بوده که مشخص میکند مقادیر مورد نظر برایشان از نوع کمّی است. متغیرهای id و fname در طراحی مدل نقشی نخواهند داشت. مدل ارائه شده توسط تکنیک رگرسیونی، دادههایی موجود از کارکنان شرکت را دریافت کرده و یک معادله خطی بین میزان هوش و کارایی به صورت زیر ارائه میکند.
بنابراین هدف پیدا کردن مقادیر و است.
بررسی رابطه خطی بین متغیرها
البته این کار را با استفاده از فهرست دستورات (Menu) و گزینه Graph و طی کردن مسیر زیر نیز میتوانید انجام دهید.
Graph - Legacy Dialogs - Scatter/Dot
تنظیمات مربوط به ترسیم نمودار پراکندگی/نقطهای در تصویر ۲ دیده میشود.

گامیهایی که برای اجری این کارها لازم است به ترتیب شمارهگذاری شدهاند. از آنجایی برای رسم توابع، متغیر مستقل را در محور افقی و متغیر (تابع) را در محور عمودی نشان میدهند، در پنجره Simple Scatterplot هم متغیر iq را در محور افقی (X Axis) و performance را در محور عمودی (Y Axis) قرار دادهایم.
با انتخاب دکمه Titles میتوانید برای نمودار عنوان انتخاب کنید. مطابق با کد بالا، عنوان را به صورت Scatterplot Performance with IQ و زیر عنوان نیز به صورت All Respondents | N = 10 در نظر گرفته میشود.


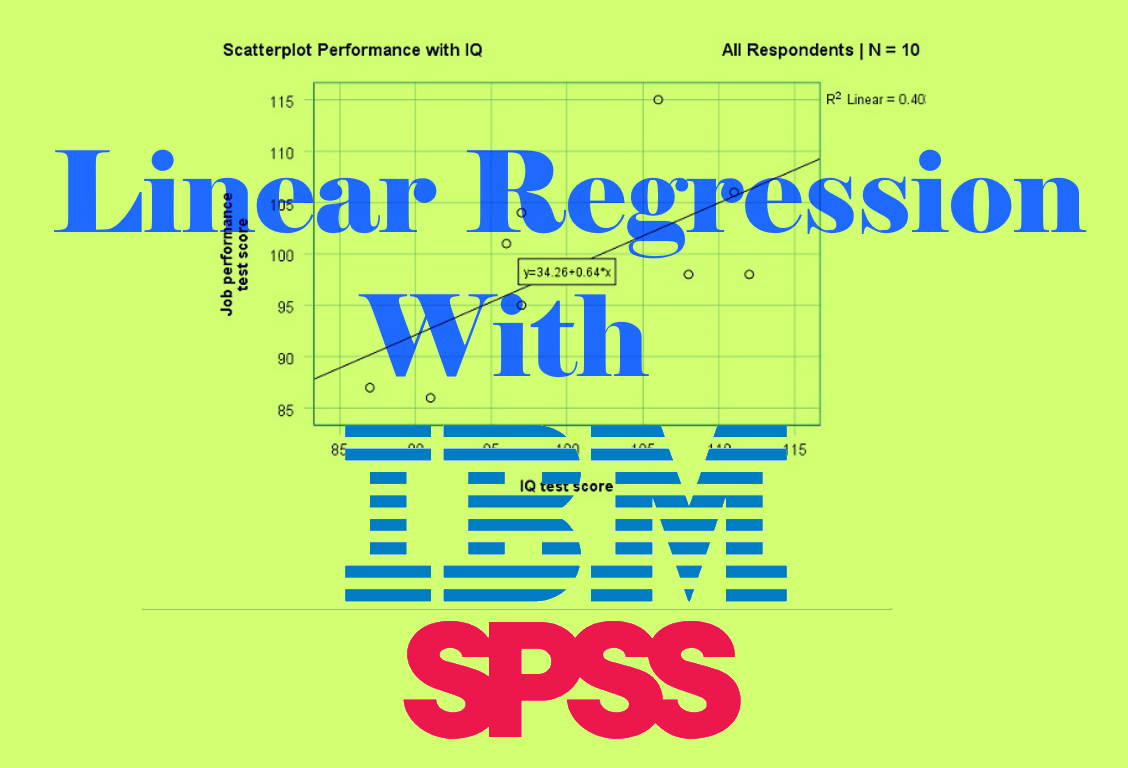
معادله خطی حاصل در تصویر ۵ قابل مشاهده است. از طرفی مربع ضریب همبستگی بین مقادیر واقعی و پیشبینی شده برای متغیر وابسته یا همان یا ضریب تعیین () نیز در نمودار دیده میشود. البته مقدار کوچک برای نشانگر ضعف در مدل رگرسیونی است. در اینجا هم مقدار کوچکی است و نمیتوان به طور کامل رابطه بین متغیر وابسته و مستقل را خطی در نظر گرفت. شاید یکی از علتهای اصلی در این حالت، کم بودن تعداد مشاهدات باشد. ولی به هر حال برای اجرای مدل رگرسیونی کار را ادامه خواهیم داد.

برآورد پارامترهای مدل و آزمون رگرسیون خطی در SPSS
برای اجرای و برآورد پارامترها و همچنین آزمون رگرسیون خطی در SPSS باید از مسیر زیر، دستور Linear Regression را اجرا کنیم.
Analyze - Regression - Linear

قطعه کدی که در ادامه مشاهده میکنید به منظور اجرای رگرسیون خطی و ترسیم نمودار باقیماندهها نوشته شده است. البته فشردن دکمه Paste در پنجره Linear Regression نیز همین کد را، با توجه به تنظیمات صورت گرفته، تولید خواهد کرد.
نتیجه محاسبات مطابق با جدولهایی که در تصویرهای بعدی مشاهده میکنید، در پنجره خروجی SPSS قرار میگیرند. ابتدا متغیرهای وابسته و مستقل در جدول Variables Entered/Removed مشخص میشوند. مشخص است که متغیر iq به عنوان متغیر مستقل وارد مدل شده و برای پیشبینی متغیر performance به کار رفته است.


ضرایب رگرسیونی یا همان برآورد پارامترها هم در جدول Coefficients ظاهر شده. مقدار ثابت یا همان «عرض از مبدا» برابر با ۳۴٫۲۶۲ و «شیب خط» نیز ۰٫۶۴۳ بدست آمده. بنابراین معادله خط به صورت زیر در خواهد آمد. توجه داشته باشید که حرف a در بالای نام این جدول در پایین به صورت زیرنویس توضیح داده شده. این شرح، مشخص میکند که متغیر وابسته در مدل رگرسیونی، Job performance test score است.
همانطور که میبینید، این معادله با معادلهای خطی که در نمودار مربوط به تصویر ۵ دیده میشود، مطابقت دارد. ولی به این موضوع نیز توجه داشته باشید که مقدار Sig برای ردیف Constant بزرگتر از ۰٫۰۵ است و این امر میتواند، فرض صفر بودن مقدار ثابت را تقویت کند. ولی از طرفی مقدار Sig برای متغیر IQ test score کمتر از ۰٫۰۵ بوده که نشانگر معنیدار بودن این پارامتر یا متغیر است. بنابراین میزان هوش با کارایی در ارتباط بوده ولی ممکن است رابطه به شکل خطی نباشد.

نمودار رسم شده برای مقایسه باقیماندههای استاندارد نسبت به مقادیر پیشبینی شده استاندارد نیز در تصویر ۱۰ دیده میشود. فرض تصادفی و ثابت بودن واریانس برای آزمون رگرسیون خطی در SPSS در این نمودار دیده میشود. اگر تغییرات باقیمانده در این نمودار به صورت افزایشی بود، میتوانستیم واریانس را صعودی و غیر ثابت در نظر بگیریم و شرط رگرسیون OLS را مخدوش اعلام کنیم. ولی خوشبختانه این نمودار چنین چیزی را نشان نمیدهد.

همانطور که در تصویر ۱۰ مشاهده میکنید، حدود تغییرات روی هر دو محور به علت استاندارد کردن مقادیر، در بازه ۲- تا ۲ است.
با توجه به درخواست مربوط به ترسیم «نمودار هیستوگرام» (Histogram) در تنظیمات پنجره plot، نموداری که در تصویر ۱۱ مشاهده میکنید، ترسیم خواهد شد و به کمک آن میتوانیم نرمال بودن متغیر وابسته (یا خطا) را برای مدل و آزمون رگرسیون خطی در SPSS مورد بررسی قرار داد.

خلاصه و جمعبندی
در این نوشتار به شیوه اجرا و آزمون رگرسیون خطی در SPSS آشنا شده و به کمک مثالی، روند اجرای محاسبات را برایتان بازگو کردیم. همانطور که دیدید، مدل رگرسیونی باید دارای شرایطی باشد تا نتیجه حاصل قابل اتکا باشد. اگر این پیشفرضها محقق نشوند، نمیتوان مقدارهای پیش بینی شده توسط مدل یا خط رگرسیونی را معتبر دانست. در چنین مواقعی بهتر است از شیوههای دیگر تکنیک رگرسیون مانند روشهای رگرسیون ناپارامتری یا رگرسیون غیر خطی استفاده کرد. رسم منحنیها و نمودارها، به درک مدل خطی در آزمون رگرسیون خطی در SPSS کمک شایانی میکند. به همین دلیل در این نوشتار هم به بررسی نحوه ترسیم این نمودارها پرداختیم.
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید
سلام آقای ری بد
متشکرم از توضیحات شما
بنده یک سوال داشتم مقدار sig مربوط به عرض از مبدا بیشتر از 0.05 است و یعنی دلیلی برای رد فرضیه صفر نداریم.
به عبارتی مدل بدون عرض از مبدا است.
آیا من اشتباه میکنم؟
ممنون میشوم راهنمایی بفرمایید.
درود بر شما و خداقوت
از مجموعه آموزشهایی که در زمینه رگرسیون داشتید برای انجام یک پروژه آماری استفاده کردم و نتیجه عالی بود.
سپاس از مجموعه خوب فرادرس بابت فراهم کردن چنین آموزشهای مفیدی
و همچنین سپاس از شما استاد فرهیخته گرامی بابت ارائه مطالب بصورت مفید و جامع و بسیار کاربردی
تندرست باشید و پیروز
خیلی خوب و آموزنده بود.
سلام جناب استاد ری بد اگر بخواهیم مدل رگرسیون خطی ارزیابی کنیم که در مقابل متغیر های جدید چگونه عملکرد دارد باید چکار کنیم ؟
خیلی ممنون ساده و روان و بسیار مفید بود
سلام
برای فصل چهار چه اطلاعاتی از جداول رگرسیون باید در جداول اورد
ممنون میشم راهنمایی بفرمایید .