


معیار ارزیابی BIC در مدل های احتمالی – از صفر تا صد
برای ارزیابی مدلهایی که برمبنای استنباط آماری ایجاد میشوند، ابزارها و معیارهای مختلف وجود دارد یکی از این ابزارها، معیار ارزیابی BIC است که میزان اطلاع از دست رفته توسط مدل را مشخص میکند. معیار BIC که مخفف Bayesian Information Criterion است، برمبنای تابع درستنمایی محاسبه شده و ارتباط نزدیکی با «معیار ارزیابی آیکاکه» (AIC) دارد.
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید


همانطور که در ادامه مشاهده خواهیم کرد، معیار ارزیابی BIC به مانند معیار AIC، نمایانگر میزان اطلاعاتی است که توسط مدل از دست رفته است و در نتیجه هر چه مقدار معیار ارزیابی BIC کوچکتر باشد، مدل مورد نظر نسبت به بقیه مدلها، بهتر و مناسبتر است. معیار ارزیابی BIC توسط «گیدون شوارتز» (Gideon Schwarz) طی مقالهای که در سال ۱۹۷۸ منتشر کرد، معرفی شد.
معیار ارزیابی BIC در مدل های احتمالی
نحوه محاسبه BIC درست به مانند معیار ارزیابی AIC است. با این تفاوت که میزان جریمه برای تعداد پارامترها در مدل بیشتر است. فرض کنید که حداکثر تابع درستنمایی را برای یک مدل آماری با ، تعداد پارامترها را با و تعداد مشاهدات را هم با نشان دهیم.
در این صورت معیار BIC برای این مدل به صورت زیر محاسبه میشود.
رابطه ۱
توجه دارید که در اینجا بیانگر همه مشاهدات بوده و نیز مقداری از پارامتر است که تابع درستنمایی را در مدل بیشینه میکند.
اگر تعداد مشاهدات زیاد باشد بطوری که بتوان از عبارت و نیز چشم پوشی کرد، میتوان رابطه قبلی را به صورت زیر بازنویسی کرد.
به این ترتیب تابع توزیع پسین را به شکل زیر مینویسیم که در آن طبق رابطه ۱ حاصل میشود.
خصوصیات معیار ارزیابی BIC
هر چند محاسبه معیار ارزیابی BIC به نظر پیچیده میرسد ولی میتوانیم خصوصیات آن را مطابق با لیست زیر فهرست کنیم.
- معیار ارزیابی BIC مستقل از توزیع پیشین است. بنابراین ارزیابی بوسیله آن بدون در نظر گرفتن تابع توزیع پیشین برای پارامتر امکان پذیر است.
- معیار BIC، میزان کارایی مدل را با توجه به تعداد پارامترها و قدرت پیشبینی دادهها ارزیابی میکند.
- تعداد پارامترها و همینطور تعداد مشاهدات در محاسبه BIC نقش داشته و تابع درستنمایی توسط این دو مشخصه جریمه میشوند تا از بروز بیشبرازش جلوگیری شود.
- از معیار BIC میتوان برای تعیین تعداد خوشههای مناسب در الگوریتمهای «خوشهبندی تفکیکی» (Partitional Clustering) استفاده کرد.
- معیار ارزیابی BIC ارتباط زیادی با معیار ارزیابی AIC دارد.
- اگر تعداد مشاهدات بسیار بیشتر از تعداد پارامترها باشد، استفاده از معیار BIC مناسب بوده و تقریبی که در محاسبات بالا به آن اشاره شد، موثرتر خواهد بود.
- از معیار BIC برای تحلیل و انتخاب ویژگی در دادههای با ابعاد بزرگ نمیتوان استفاده کرد.
شمارش تعداد پارامترها
مدلهای آماری برحسب پارامترها، مشخص و این پارامترها نیز توسط مشاهدات برآورد میشوند. برای مثال در یک مدل رگرسیون خطی ساده که براساس یک متغیر وابسته و مستقل شکل میگیرد، رابطه پارامتری بین متغیرهای مستقل و وابسته به صورت زیر نوشته میشود.
به نظر میرسد که در این مدل، یک متغیر مستقل به نام وجود داشته و پارامتر مدل و برای ایجاد رابطه این متغیر با متغیر وابسته یعنی به کار رفتهاند. از طرفی واریانس جمله خطا نیز باید برآورد شود تا خصوصیات عبارت یا جمله خطا که میانگینی برابر با صفر دارد نیز مشخص شود. بنابراین تعداد پارامترها یا مقدار خواهد بود.
محاسبه معیار ارزیابی BIC برای خوشهبندی k-میانگین
رابطه ۲
در اینجا مرکز خوشه ام و نیز انحراف معیار آن است. مشخص است که تیز تعداد خوشهها و ، تعداد مشاهدات را نشان میدهد. به نظر میرسد که در این رابطه تابع درستنمایی به کار نرفته است. البته این امر به علت اینکه توزیع دادهها مشخص نیست کاملا صحیح است. ولی باید به یاد داشت که منظور از بیشینه تابع درستنمایی در شیوه محاسبه BIC، تعیین مقداری است که به واسطه آن میزان برازش دادهها با مدل، اندازهگیری شود.
در روشهای خوشهبندی دادهها، یکی از ملاکها برای تعیین خوشهبندی مناسب، تعیین مقدار مجموع مربعات فاصله نقاط از مرکز هر خوشه است که به نوعی تابع هدف در خوشهبندی k-میانگین محسوب میشود. در الگوریتم خوشهبندی k-میانگین باید این تابع هدف کمینه شود. به همین ترتیب در محاسبه BIC به جای تابع درستنمایی از مجموع مربعات فاصله نقاط از میانگین هر خوشه استفاده میشود تا برازش مدل خوشهبندی برحسب تعداد خوشهها اندازهگیری شود. واضح است که این مقدار بوسیله تعداد مشاهدات و تعداد پارامترها (تعداد خوشهها) جریمه شده است تا از بیشبرازش جلوگیری شود. در نتیجه از رابطه ۲ میتوان برای تعیین تعداد خوشههای مناسب در هنگام استفاده از الگوریتم k-میانگین استفاده کرد. به این ترتیب را مقداری در نظر میگیریم که در آن BIC کمینه شود.
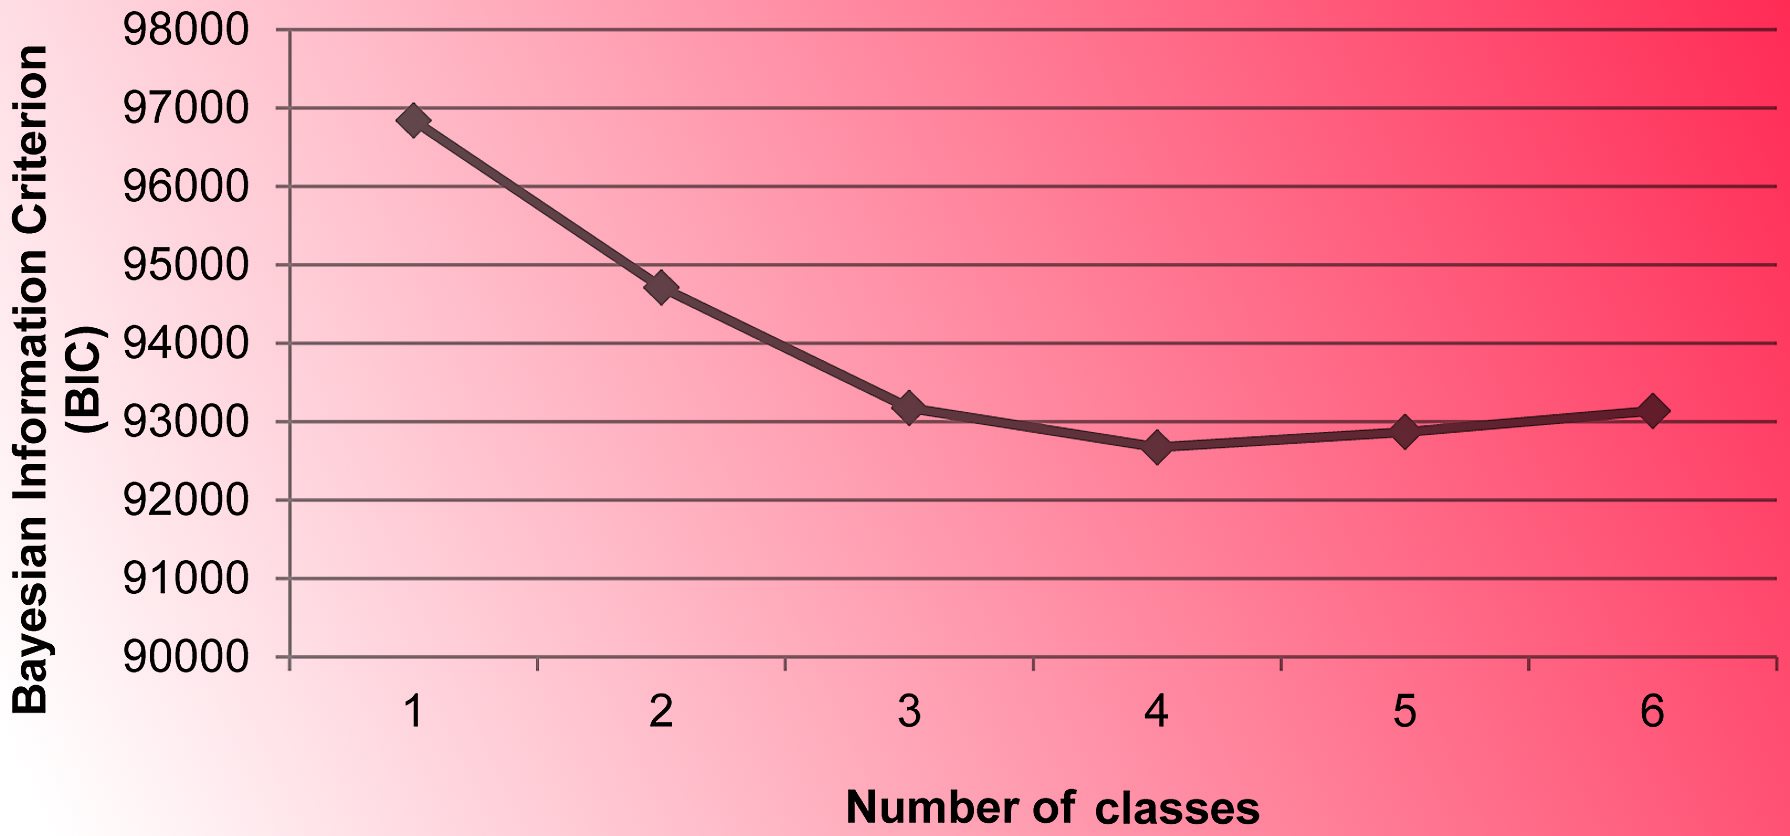
فرض کنید برای یک نمونه داده فرضی باید عمل خوشهبندی با الگوریتم k-میانگین صورت بگیرد ولی تعداد خوشه مناسب از قبل مشخص نیست. برای استفاده از محاسبه شاخص BIC یا مشابه آن AIC میتوان مقدار را پیدا کرد که برای آن میزان واریانس یا همان مجموع مربع فاصله نقاط از مراکز خوشهها کمترین مقدار را دارد. البته واضح است که هر چه تعداد خوشهها بیشتر شود، میزان واریانس درون خوشهها کاهش مییابد ولی از طرفی مقدار جریمه معیار BIC و AIC از این امر جلوگیری میکنند که تعداد خوشهها بسیار زیاد شوند. تصویر زیر چنین حالتی را نشان میدهد.

در نمودار بالا، محور افقی تعداد خوشهها و محور عمودی نیز مقدار BIC را نشان میدهد. بنابراین به نظر میرسد جایی که «منحنی BIC کمترین مقدار را نشان میدهد، مقدار بهینه برای تعداد خوشهها است. بنابراین اگر تعداد خوشهها را مقداری بین ۱۰۰ تا ۲۰۰ انتخاب کنیم، معیار BIC کمینه خواهد بود.
اگر مطلب بالا برای شما مفید بوده است، آموزشهایی که در ادامه آمدهاند نیز به شما پیشنهاد میشوند:
- مجموعه آموزشهای آمار، احتمالات و دادهکاوی
- آموزش تخمین خطای طبقه بندی یا Classifier Error Estimation
- مجموعه آموزشهای دادهکاوی و یادگیری ماشین
- بیش برازش (Overfitting)، کم برازش (Underfitting) و برازش مناسب — مفهوم و شناسایی
- تابع درستنمایی (Likelihood Function) و کاربردهای آن — به زبان ساده
- خوشه بندی k میانگین (k-means Clustering) — به همراه کدهای R
^^
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید
با سلام منون از توضیحات خوبتون. اگر امکانش هست رفرنس مطالب این بخش را به ادرس بنده ایمیل کنید که در مقالات استفاده کنم.
ویکی رو بزن