



فیلتر کالمن – به زبان ساده
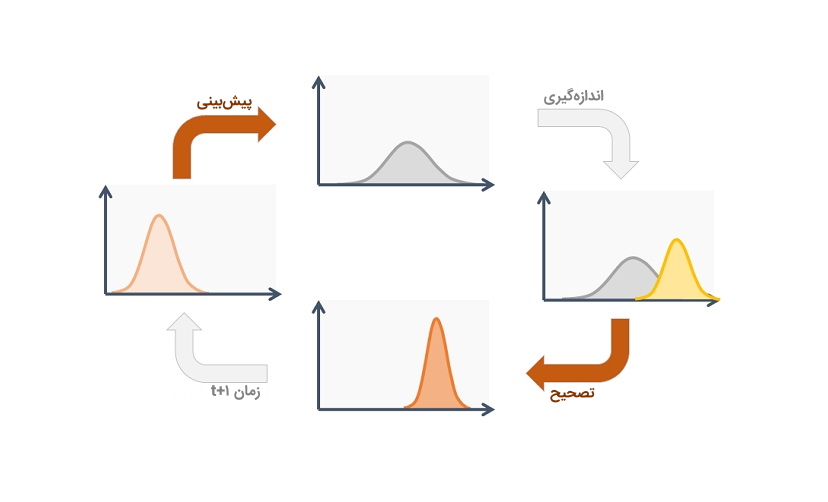
فیلتر کالمن (Kalman Filter) یک تخمینگر است که از تخمین حالت قبل و مشاهده فعلی برای محاسبه تخمین حالت فعلی استفاده میکند و یک ابزار بسیار قوی برای ترکیب اطلاعات در حضور نامعینیها است. در برخی موارد، توانایی فیلتر کالمن برای استخراج اطلاعات دقیق خیره کننده است. فیلتر کالمن مدتهاست که به عنوان راهحل بهینه برای بسیاری از کارهای ردیابی و پیشبینی دادهها مورد استفاده قرار میگیرد.


فیلتر کالمن چیست؟
هر جایی که اطلاعات نامعینی درباره یک سیستم دینامیکی داشته باشیم، میتوانیم با استفاده از فیلتر کالمن تخمین مناسبی از تغییرات سیستم در آینده ارائه کنیم. فیلترهای کالمن برای سیستمهایی که مدام در حال تغییرند، ایدهآل هستند. مزیت فیلترهای کالمن این است که به حافظه کمی نیاز دارند، زیرا به حافظهای جز برای نگهداری اطلاعات وضعیتهای قبلی نیاز ندارند. همچنین این فیلترها بسیار سریع هستند و به همین دلیل برای مسائل زمان حقیقی و سیستمهای تعبیهای مناسب هستند.
در نگاه اول، ظاهر ریاضیات مربوط به فیلتر کالمن، ترسناک و مبهم به نظر میرسد. اما کاملاً برعکس است و اگر به درستی برای یادگیری آن اقدام کنیم، فهم آن بسیار ساده خواهد بود. در این آموزش سعی میکنیم فیلتر کالمن را به صورت بصری و ساده شرح دهیم. برای یادگیری فیلتر کالمن، لازم است کمی درباره احتمال و ماتریسها بدانیم.
با یک مثال ساده شروع میکنیم.
با یک فیلتر کالمن چه کاری میتوانیم انجام دهیم؟
فرض کنید ربات کوچکی ساختهایم که میتواند آزادانه در یک جنگل حرکت کند. این ربات برای آنکه مسیریابی کند، باید بداند دقیقاً در کجا قرار گرفته است.

وضعیت یا حالت (State) ربات را با نشان میدهیم که شامل موقعیت (Position) و سرعت (Velocity) است:
حالت یا بردار حالت، شامل اعدادی است که پیکربندی سیستم را نشان میدهند. در مورد این ربات، حالت شامل موقعیت و سرعت است. برای مثال، حالت یک سیستم میتواند اطلاعاتی درباره مقدار سیال یک مخزن، دمای موتور خودرو، موقعیت انگشت کاربر روی صفحه لمسی یا هر مورد دیگری باشد که ما بسته به نیاز، آن را در نظر میگیریم.
رباتی که درباره آن بحث کردیم، یک سنسور GPS با دقت تقریباً ۱۰ متر دارد که مقدار تقریباً مناسبی است. اما لازم است موقعیت ربات به صورت دقیقتر و کمتر از ۱۰ متر نیز در اختیار باشد، زیرا در جنگل صخرهها و گودالهایی وجود دارد و اگر ربات چند قدم اشتباه گام بردارد، ممکن است مثلاً درون گودالی بیفتد و دچار مشکل شود. بنابراین، وجود GPS به تنهایی برای مسیریابی ربات کافی نیست.

ممکن است چیزهای دیگری نیز درباره ربات بدانیم. مثلاً میدانیم فرمانهایی به موتور چرخها ارسال میشود و همچنین، اگر ربات در جهت خاصی حرکت کند و مشکلی برایش پیش نیاید، همان جهت حرکت قبلی را ادامه خواهد داد. اما اطلاعاتی درباره حرکت ربات در دست نیست؛ بنابراین، تعداد دور چرخهای ربات، نمیتواند دقیقاً تعیین کند که چه اندازه حرکت کرده است و در نتیجه، پیشبینی کامل نخواهد بود.
سنسور GPS اطلاعاتی را درباره حالت ربات به ما میدهد که البته غیرمستقیم بوده و اصطلاحاً نامعینیهایی دارد. پیشبینی ما نیز، اطلاعاتی را درباره چگونگی حرکت ربات به دست میدهد که غیرمستقیم بوده و با نایقینی یا نامعینی همراه است.
اما آیا اگر همه اطلاعات در دسترس استفاده کنیم، میتوانیم پاسخ بهتری نسبت به تخمینی که خود اطلاعات ارائه میکنند داشته باشیم؟ قطعاً بله و این دقیقاً همان کاری است که فیلتر کالمن انجام میدهد.
مسئله از دیدگاه فیلتر کالمن چگونه است؟
حالت سادهای را در نظر بگیرید که فقط از موقعیت و سرعت تشکیل شده است:
موقعیت و سرعت واقعی را نمیدانیم و طیف وسیعی از ترکیبهای موقعیت و سرعت وجود دارند که میتوانند درست باشند، اما تعدادی از آنها نسبت به سایرین به واقعیت نزدیکترند.


در شکل بالا، موقعیت و سرعت ناهمبسته (Uncorrelated) هستند. این بدین معنی است که وضعیت یک متغیر، اطلاعاتی درباره متغیر دیگر به دست نمیدهد.
شکل زیر، مورد جذابتری را نشان میدهد که در آن، موقعیت و سرعت همبسته (Correlated) هستند. بنابراین، احتمال مشاهده یک موقعیت خاص به سرعت بستگی خواهد داشت.

اگر برای مثال بخواهیم موقعیت جدید را بر اساس موقعیت قبلی تخمین بزنیم، این مورد (همبستگی) وجود خواهد داشت. اگر سرعت زیاد باشد، احتمالاً مسافت بیشتری پیموده میشود و در نتیجه، موقعیت دورتر خواهد بود. اگر به آرامی حرکت کنیم، به اندازه کمی دور خواهیم شد.
این رابطه بسیار مهم است، زیرا اطلاعات بیشتری به ما میدهد. به عبارت بهتر، یک اندازهگیری، اطلاعاتی را درباره سایر متغیرها ارائه میکند. هدف فیلتر کالمن نیز همین است که میخواهیم در حد امکان، اندازهگیریهای نامعین را به عنوان اطلاعاتِ بیشتر، فشرده کنیم.

تعریف مسئله در قالب ماتریسها
در این بخش، دانش خود درباره حالت را به عنوان یک حباب یا توده گوسی (Gaussian blob) مدل میکنیم.
بنابراین، به یک اطلاعات دوبخشی در زمان نیاز داریم. بهترین تخمین را مینامیم (که همان میانگین است) و ماتریس کوواریانس را به صورت زیر مینویسیم:
توجه کنید که در اینجا، فقط سرعت و موقعیت را در نظر گرفتهایم و بردار حالت میتواند هر تعداد متغیر حالت داشته باشد.
اکنون باید حالت فعلی (در زمان ) و پیشبینی حالت بعدی در زمان را تعیین کنیم. لازم به یادآوری است که اطلاعی نداریم کدام حالت واقعی است، اما این موضوع تأثیری در عملکرد پیشبینی ندارد؛ زیرا پیشبینی با همه آنها کار میکند و توزیع جدیدی را نتیجه خواهد داد.

مرحله پیشبینی را با ماتریس نمایش میدهیم.

پیشبینی برای هر نقطه از تخمین اولیه (Original) انجام میشود و آن را به یک محل پیشبینی شده جدید انتقال میدهد.
اکنون بررسی میکنیم که چگونه باید از یک ماتریس برای پیشبینی موقعیت و سرعت در لحظه بعدی استفاده کنیم. از فرمول پایهای سینماتیک زیر استفاده میکنیم:
$$ \large \begin {split}<br /> \color{deeppink} { p _ k } & = \color {royalblue} { p _ { k - 1 } } + \Delta t & \color {royalblue} { v _ { k - 1 } } \\<br /> \color {deeppink} { v _ k } & = & \color {royalblue} { v _ { k - 1 } }<br /> \end {split} $$مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید

فوق العاده بود
سلام
مطلب عالی بود من از مطالب و آموزش های سایت فرادرس زیاد استفاده می کنم و آن را هم به خیلی از دوستان معرفی کردم موضوع دوم کار با ارزشی انجام دادید که می شود از مطالب سایت فایل PDF گرفت من موقع تحقیق درباره پروژه هایم منابع آنها را به صورت PDF در کنارش نگهداری می کنم فقط اگر به لحاظ فنی مقدور است تبلیغات داخل صفحه را از فایل PDF حذف کنید به طور مثال موقع دریافت فایل از سایت آنالوگ دیواس و برخی سایت هایی که نکات فنی ارائه می دهند تبلیغات داخل صفحه در فایل خروجی وجود ندارد
تشکر و خداقوت
سلام بسیار عالی
سلام. از توضیحتان بسیار ممنونم. آیا ممکن است دربارۀ پیاده سازی فیلتر کالمن در ورژن های جدید برنامۀ متلب (که دارای دستور آمادۀ کالمن هستند.)، توضیح بفرمایید. آیا می توان داده های حسگر را به عنوان بردار کنترلی وارد مسأله کرد؟
بسیار ممنون، عرفانی
من که چیزی سر در نیاوردم:((((
این فرمولای عجیب غریب چیه
چرا یکی بطور ساده این فیلتر رو توضیح نداده
چون ساده نیس
فوق العاده بود بینظیر
سلام.
خوشحالیم که این آموزش برایتان مفید بوده است.
شاد و پیروز باشید.
سلام
مطلب خیلی خوبی بود.
همین که زحمت ترجمه مطلب رو کشیدید خیلی ارزش داره. ولی اگر لینک مطلب اصلی رو هم می گذاشتید هم چیزی از ارزش های شما کم نمی شد و هم امانت رو رعایت کرده بودید.
سلام، وقت شما بخیر؛
منابع کلیه مطالب مجله فرادرس در انتهای آنها و پس از بخش معرفی مطالب و آموزشهای مرتبط ذکر شدهاند.
از همراهی شما با مجله فرادرس بسیار سپاسگزاریم.
عالی بود
ممنون
جالب بود
سلام.امکان دانلود این مطلب بصورت pdf یا word هست؟
عالی و کامل بود. ممنون
عالی بود
ممنون
ممنون
تشکر از بیان بسیار عالی شما. خواهشمندم لطفاً راهنمایی بفرمایید که:
1. مقادیر ماتریس Bk (ماتریس کنترل) و بردار Uk (بردار کنترل) در کاربردهای مختلف چگونه محاسبه میشود.
2. نحوه محاسبه Qk (کواریانس نویز).
3. در ماتریس Hk (که فرمودید سنسورها را مدل میکند) دقیقاً چه مقایری قرار میگیرد.
4. Rk کواریانس نامعینی (یعنی نویز سنسور) چگونه محاسبه میشود.
با سپاس فراوان
سلام.
مقادیر ماتریس و بردار کنترل و مقادیر کوواریانس نویز، بستگی به شرایط هر مسأله دارد. ماتریس Hk، ماتریسی با مقادیر صفر و یک است، که حسگر مورد نظر را وارد مسأله می نماید. به طور مثال، اگر تمام مقادیر بردار حالت، اندازهگیری شده باشند، ماتریس Hk، ماتریس همانی خواهد بود.
سپاسگزارم
خیلی عالی
تشکر
عالی بود
ممنون