


دیتاست چیست؟ – آنچه باید درباره مجموعه داده ها بدانید
- خواهید توانست ساختار و اجزای اصلی دیتاست را شرح دهید.
- یاد میگیرید میان داده خام، دیتاست و پایگاه داده تمایز بگذارید.
- میآموزید انواع دیتاست و کاربردهای کلیدی هر یک را تشخیص دهید.
- یاد خواهید گرفت هدف تقسیمبندی دیتاست در یادگیری ماشین چیست.
- میآموزید با منابع معتبر و ابزارهای ساخت دیتاست کار کنید.
- خواهید فهمید ویژگیهای کلیدی یک دیتاست باکیفیت چه هستند.

مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید


در این مطلب، ابتدا به پرسش دیتاست چیست پاسخ میدهیم و پس از معرفی انواع دیتاستها، با نحوه تقسیم و ارزیابی دادهها آشنا میشویم. سپس شرحی از ویژگیهای مهم دیتاستها ارائه داده و با بررسی تعدادی از نمونههای کاربردی، روشهای ایجاد دیتاستها را یاد میگیریم. در انتهای این مطلب از مجله فرادرس، به معرفی برخی از رایجترین منابع دریافت دیتاستها میپردازیم و پس از بیان تفاوت سه مفهوم داده، پایگاه داده و مجموعهداده یا دیتاست، به چند مورد از پرسشهای متداول در این زمینه پاسخ میدهیم.
مجموعه داده یا دیتاست چیست؟

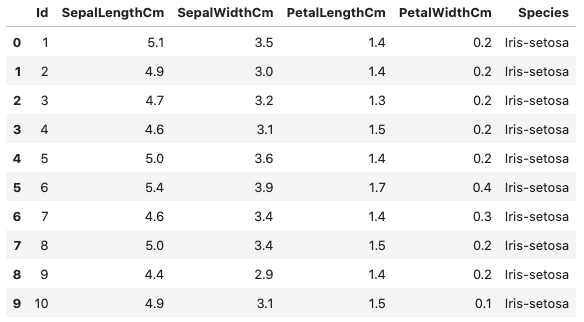
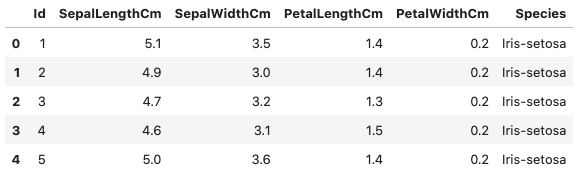
این دیتاست، یکی از مشهورترین مجموعهدادههای مورد استفاده در یادگیری ماشین است که بر اساس چند ویژگی، گونههای مختلف گیاه «زنبق» (Iris) را طبقهبندی کرده است. در طراحی و ساخت هر مدل یادگیری ماشین، ویژگیهای ورودی دیتاست نقش منابع یادگیری را داشته و خروجی پیشبینی شده با ویژگی خروجی دیتاست مقایسه میشود. در زیر، ویژگیهای ورودی و خروجی دیتاست Iris فهرست شده است:
- ویژگیهای ورودی: «طول کاسبرگ» (Sepal Length)، «عرض کاسبرگ» (Sepal Width)، طول گلبرگ (Petal Length) و «عرض گلبرگ» (Petal Width).
- ویژگی خروجی: «نوع گونه» (Species).
انواع دیتاست چیست؟
در راستای پاسخ دادن به پرسش دیتاست چیست، آشنایی با انواع دیتاستها نیز ضرورت دارد.
از جمله انواع مختلف دیتاستها میتوان به موارد زیر اشاره کرد:

- دیتاستهای «عددی» (Numerical): نمونه دادههای عددی مانند دما، رطوبت و امتیاز که قابلیت اعمال معادلات ریاضی بر آنها وجود دارد.
- دیتاستهای «طبقهبندی شده» (Categorical): این دیتاستها شامل دادههایی همچون رنگ، جنسیت، ورزش و شغل میشوند که میتوان آنها را در دسته یا گروههای مجزا طبقهبندی کرد.
- دیتاستهای «مبتنیبر وب» (Web-based): این نوع از دیتاستها از طریق ارسال درخواست HTTP و فراخوانی واسطهای برنامهنویسی کاربردی یا همان API، جمعآوری شده و در «تحلیل داده» (Data Analytics) مورد استفاده قرار میگیرند. ذخیرهسازی این دیتاستها اغلب با فرمت JSON صورت میگیرد.
- دیتاستهای «سری زمانی» (Time Series): متشکل از دادههایی مانند تغییرات جغرافیایی یک ناحیه که در بازه زمانی مشخصی جمعآوری شدهاند.
- دیتاستهای «مبتنیبر تصویر» (Image-based): اغلب از دیتاستهایی که شامل نمونههای تصویری هستند، در کاربردهای مقایسهای مانند تفاوت علائم چند نوع بیماری مختلف استفاده میشود.
- دیتاستهای «ترتیبی» (Ordered): دادههایی که بدون ترتیب ارزشی ندارند. مانند امتیازاتی که کاربران یک پلتفرم ویدئویی برای فیلمها ثبت کردهاند.
- دیتاستهای «بخشبندی شده» (Partitioned): متشکل از دادههایی که در چند گروه مجزا بخشبندی شدهاند.
- دیتاستهای «فایل محور» (File-based): دیتاستهایی که در قالب فایلهایی با پسوند csv، json یا xlsx ذخیره میشوند.
- دیتاستهای «دو متغیره» (Bivariate): در این قبیل از دیتاستها، دو کلاس یا ویژگی با یکدیگر «همبستگی» (Correlation) مستقیم دارند. به عنوان مثال، میان ویژگیهای وزن و قد ارتباط مستقیمی وجود دارد.
- دیتاستهای «چند متغیره» (Multivariate): همانطور که از نام آن پیداست، در دیتاستهای چند متغیره میان دو یا تعداد بیشتری از کلاسها همبستگی وجود دارد. به عنوان مثال، دو متغیر تعداد غیبت و نمرات کلاسی، در ارتباط مستقیم با معدل دانشآموز هستند.
تقسیم و ارزیابی دیتاست ها در یادگیری ماشین
کاربرد دیتاست تنها در فرایند آموزش خلاصه نمیشود. همزمان با بهکارگیری «مجموعه آموزشی» (Training Set) برای آموزش دادن مدل یادگیری ماشین، قسمت دیگری از دیتاست نیز با عنوان «مجموعه آزمایشی» (Testing Set)، در ارزیابی عملکرد مدل مورد استفاده قرار میگیرد.
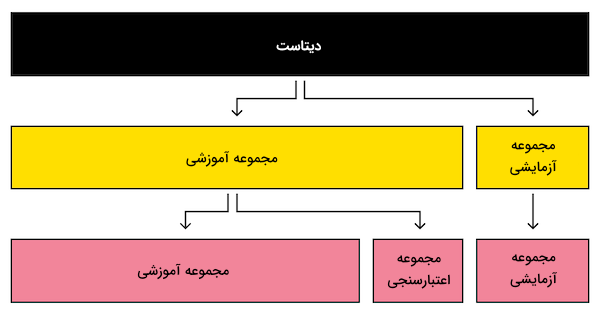
سپس در مرحلهای اختیاری و برای اجتناب از آموزش دیدن مدل با دادههای تکراری و در نتیجه ارائه پیشبینیهای «سوگیرانه» (Biased)، میتوان مجدد دیتاست را به بخش سومی با عنوان «مجموعه اعتبارسنجی» (Validation Set) تقسیم کرد.
چگونه کار کردن با دیتاست ها را یاد بگیریم؟

ویژگی های یک دیتاست چیست؟
پس از آنکه یاد گرفتیم دیتاست چیست، در این بخش با مفهوم ویژگیهای یک دیتاست آشنا میشویم. وقتی صحبت از ویژگیهای دیتاست میشود، اغلب به ستونهای مجموعهداده اشاره داریم. ویژگیها مهمترین بخش از هر دیتاستی هستند؛ چرا که تمامی فرایند توسعه مدل و پیشبینی خروجی نهایی بر اساس همین ویژگیها انجام میشود. نوع داده و قابلیتهای هر ویژگی، نسبت به مجموعهداده و هدف مسئله متفاوت است. چند مورد از ویژگیهای رایج دیتاستها را در زیر فهرست کردهایم:


- ویژگیهای «عددی» (Numerical): ویژگیهایی مانند وزن و ارتفاع که هم میتوانند در بازهای پیوسته مانند اعداد اعشاری قرار داشته و هم مقادیر گسسته و صحیح را بپذیرند.
- ویژگیهای «طبقهبندی شده» (Categorical): این نوع از ویژگیها در چند کلاس یا گروه مجزا مانند جنسیت و انواع رنگها قابل جداسازی هستند.
- «فراداده» (Metadata): توصیفی جامع از دادهها که در دیتاستهای بزرگ کاربرد دارد. هنگام واگذاری وظیفه مدیریت و کار با مجموعهداده به فردی جدید، وجود چنین ویژگی باعث افزایش بهرهوری و صرفهجویی در زمان میشود.
- «اندازه دادهها» (Size of the Data): این ویژگی به تعداد نمونهها و همچنین ستونهای موجود در هر دیتاست اشاره دارد.
- «فرمت دادهها» (Formatting of Data): امروزه دیتاستها در فرمتهای متنوع و بهصورت آنلاین در دسترس همگان قرار دارند. از جمله رایجترین فرمتها، میتوان به مواردی همچون XML، CSV، JSON یا «زبان نشانهگذاری گسترشپذیر» (Extensible Markup Language)، جداول کتابخانه Pandas در زبان برنامهنویسی پایتون که با عنوان Dataframe شناخته میشوند و فایلهای نرمافزار اِکسل با پسوندهای xlsx یا xlsm اشاره کرد. بهطور معمول، مجموعهدادههای حجیم، بهویژه مواردی که شامل تصاویر میشوند را میتوان با فرمت فشرده شده Zip از اینترنت دریافت و سپس از حالت فشرده خارج کرد.
- «متغیر هدف» (Target Variable): ویژگی که مقادیر آن با خروجی مدل یادگیری ماشین مقایسه شده و نقش مهمی در فرایند آموزش دارد.
- «دادههای ورودی» (Data Entry): هر مقدار داده مجزایی که در دیتاست مشاهده میشود، یک داده ورودی است.
نمونه هایی از انواع دیتاست
در فضای اینترنت برای هر مسئله و کاربردی، بیش از هزاران دیتاست وجود دارد. برای دانلود چنین دیتاستهایی میتوانید به وبسایتهایی همچون Kaggle و UCI Machine Learning Repository مراجعه کنید. در ادامه این بخش، نگاهی به چند مورد از دیتاستهای مشهور و رایج در زمینه یادگیری ماشین میاندازیم.
۱. دیتاست شهر های ایالت تامیل نادو کشور هند
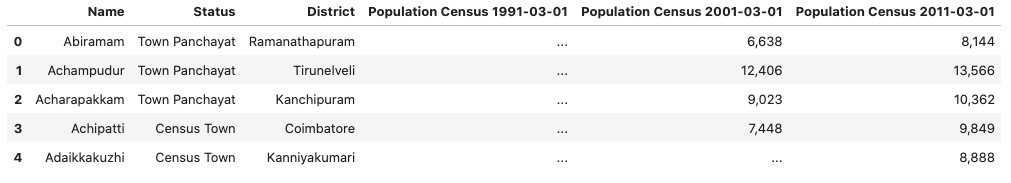
این دیتاست را میتوانید از سایت Kaggle با عنوان Tamilnadu Population و فرمت CSV دریافت کنید. در این دیتاست، تراکم جمعیت مناطق مختلف ایالت «تامیل نادو» (Tamil Nadu) هند اعلام شده است؛ ویژگی که آن را به گزینه مناسبی برای تحلیل داده و آموزش مدلهای یادگیری ماشین تبدیل میکند. بهطور معمول، از این نوع دیتاستها برای تکمیل اطلاعات میدانی استفاده میشود.
۲. دیتاست گونه های گیاه زنبق
۳. دیتاست ریسک اعتباری افراد مقیم کشور آلمان
روش های ایجاد دیتاست

۱. تولید داده با پایتون
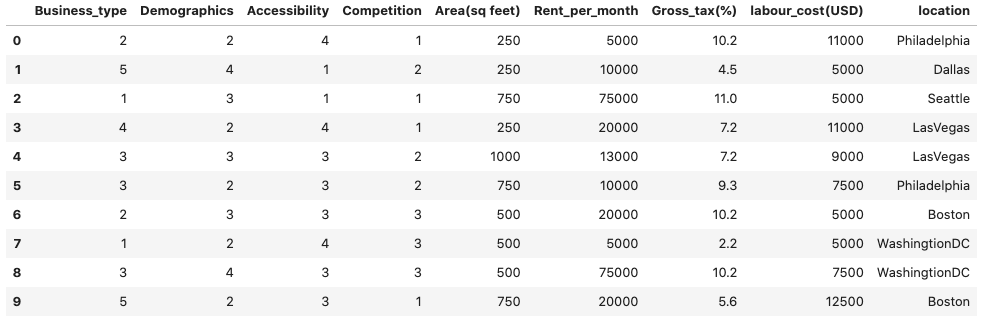
pip install numpypip install pandasهمانطور که در تصویر زیر یعنی خروجی اجرای قطعه کد بالا نیز مشاهده میکنید، دیتاست ایجاد شده با نام autogen_data.csv ، مجموعهدادهای است متشکل از اطلاعات انواع کسبوکارها با ستون یا همان ویژگیهای زیر:
- «نوع کسبوکار» (Business Type)
- «اطلاعات جمعیتی» (Demographics)
- «دسترسپذیری» (Accessibility)
- «رقابت» (Competition)
- «مساحت» (Area)
- «اجاره در ماه» (Rent Per Month)
- «مالیات بر درآمد» (Gross Tax)
- «هزینه نیروی کار» (Labour Cost)
- «موقعیت مکانی» (Location)
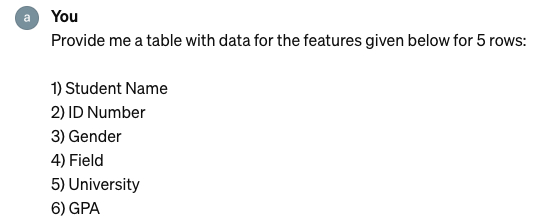
۲. ایجاد دیتاست با هوش مصنوعی
خروجی مانند تصویر زیر است:
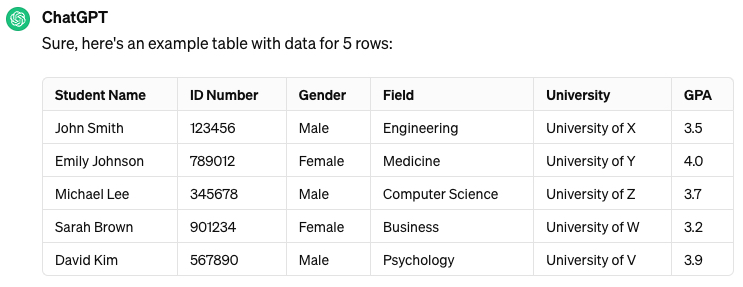
با بهرهگیری از این روش، میتوان مقادیر داده بسیاری برای آموزش دادن مدلهای یادگیری ماشین تولید کرد.
معرفی منابع دریافت انواع دیتاست
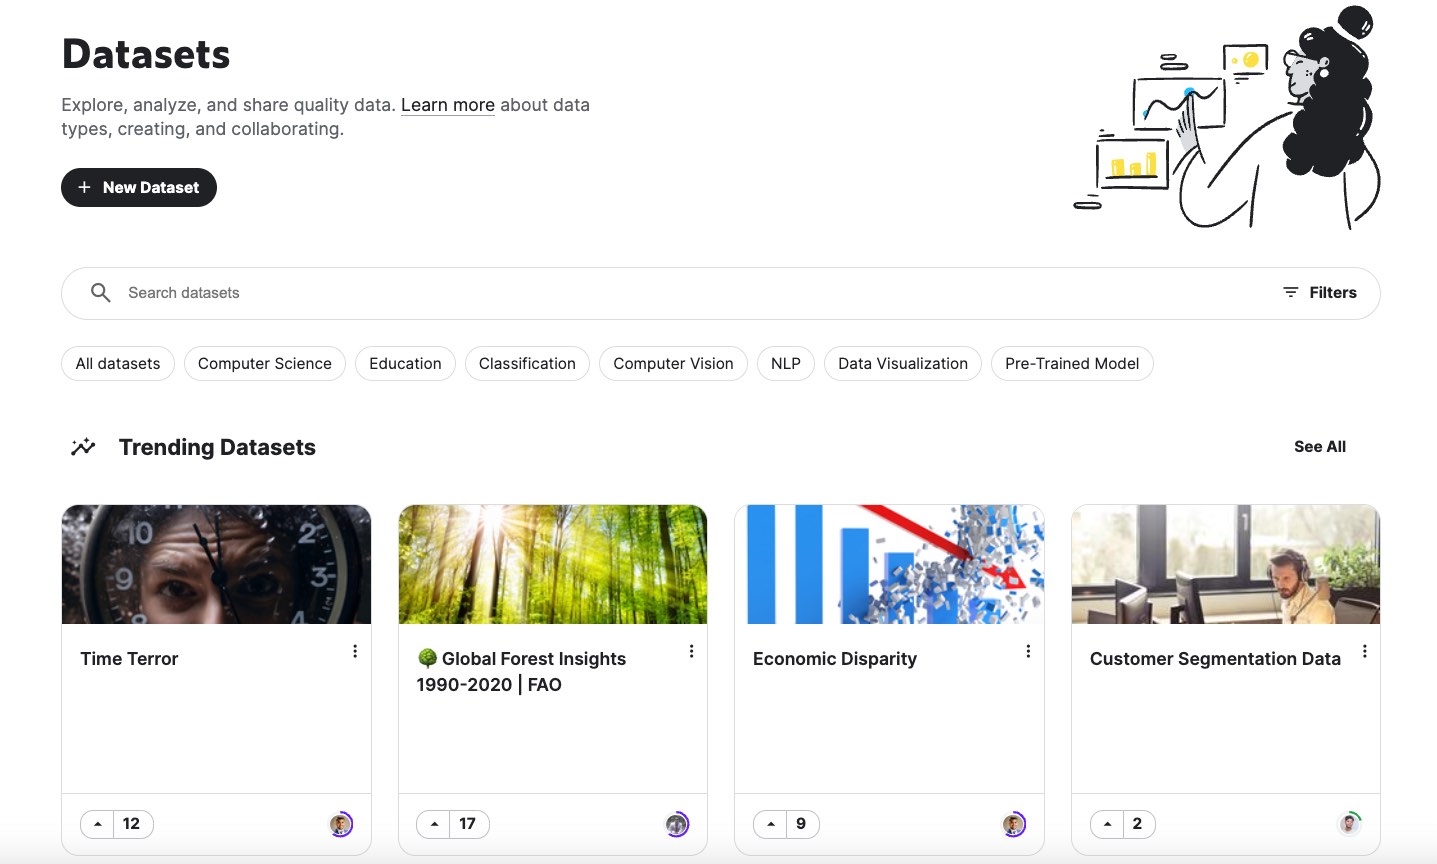
در ادامه پاسخ دادن به پرسش دیتاست چیست، بهترین راه برای مسلط شدن بر مفاهیمی که تا اینجا مرور کردهایم، تحلیل و در نهایت طراحی الگوریتمهای یادگیری ماشین بر اساس دیتاستهای رایج و کاربردی است. پایگاههای داده فراوانی برای دریافت دیتاستها وجود دارد؛ اما منابعی که در این بخش معرفی میکنیم، در واقع نمونههایی بوده که از محبوبیت بیشتری در میان متخصصان و افراد حرفهای حوزه علم داده برخوردار هستند.
۱. Kaggle
۲. Google Dataset Search
۳. GitHub
۴. World Bank Open Data
۵. Data.world
۶. DataHub
۷. Humanitarian Data Exchange
۸. FiveThirtyEight
۹. UCI Machine Learning Repository

۱۰. Academic Torrents Data
تفاوت داده، پایگاه داده و دیتاست چیست؟


داده
به هر موجودیتی مانند مقادیر «عددی» (Numerical) یا «طبقهبندی شده» (Categorical) که قابل شمارش یا جداسازی باشد، «داده» (Data) گفته میشود. با این حال، دادهها زمانی ارزشمند شده و قابل تجزیه و تحلیل هستند که با یکدیگر ترکیب شده و مجموعهای از دادهها را تشکیل دهند.
دیتاست یا مجموعه داده
پایگاه داده
در جدول زیر، خلاصهای از مقایسه سه مفهوم داده، مجموعهداده و پایگاه داده را ملاحظه میکنید.
| داده | مجموعهداده | پایگاه داده |
| شامل ویژگیها و اطلاعات خام است. | شامل ساختارهای داده مانند جداول و مجموعهها است. | متشکل از مجموعهدادههایی با فرمت یکسان است. |
| به تنهایی فاقد محتوا و نامرتب است. | دادهها در قالب چندین سطر و ستون سازماندهی میشوند. | دادهها در جداولی ذخیره شدهاند که ممکن است چندین بُعد داشته باشند. |
| دارای اطلاعات اولیهای بوده و پایه و اساس دیتاستها و همچنین پایگاههای داده را تشکیل میدهد. | دادهها را منظم ساخته و موجب استخراج اطلاعات مفیدی میشود. | متشکل از دادههای ساختارمند و مرتبط به یکدیگر است. |
| به دلیل فقدان ساختار، قابل تغییر نیست. | با استفاده از ابزارهایی مانند زبان برنامهنویسی پایتون، امکان ایجاد تغییر در آن وجود دارد. | از طریق مجموعهای از دستورات و کوئریهای پرسوجو، قابل تغییر است. |
| نیازمند پیشپردازش و تبدیل به موجودیتی قابل استفاده است. | در مواردی همچون تحلیل داده، مدلسازی و مصورسازی کاربرد دارد. | پردازش داده از طریق جابهجایی اطلاعات انجام میشود. |
سوالات متداول پیرامون دیتاست چیست؟
پس از آنکه یاد گرفتیم دیتاست چیست و با روش استفاده از انواع مختلف آن نیز آشنا شدیم، حال زمان خوبی است تا در این بخش از مطلب مجله فرادرس، به چند مورد از سوالات پرتکرار در این زمینه پاسخ دهیم.
مفهوم دیتاست چیست؟
مجموعهای سازماندهی شده از دادهها که با عنوان دیتاست شناخته میشود. عمده کاربرد دیتاستها در یادگیری ماشین، کسبوکار و امور مالی است؛ حوزههایی که برای توسعه و تصمیمگیری آگاهانه به چنین ابزاری نیاز دارند.
انواع دیتاست چیست؟
به عنوان چند نمونه رایج از انواع دیتاست، میتوان به موارد زیر اشاره کرد:
- دیتاستهای عددی
- دیتاستهای طبقهبندی شده
- دیتاستهای ترتیبی
- دیتاستهای بخشبندی شده
- دیتاستهای چند متغیره

دیتاستها چه ویژگیهایی دارند؟
هر دیتاست ویژگیهای منحصربهفردی دارد؛ از جمله:
- ویژگیهای طبقهبندی شده
- فراداده
- تعداد دادهها
- فرمت دادهها
- متغیر هدف
اهمیت دیتاست در یادگیری ماشین چیست؟
نقش دیتاست در شکل دادن به توانایی یادگیری مدلها و در نتیجه پیشبینی دقیقتر خروجی است. با استفاده از دیتاستها میتوانید مدل یادگیری ماشین خود را آموزش داده و همچنین معیاری برای ارزیابی دقت نهایی داشته باشید.
جمعبندی
شاید جمعآوری انواع دیتاستها کار آسانی بهنظر برسد و اینطور فکر کنید که باید بیشتر زمان و منابع خود را صرف ساخت مدل یادگیری ماشین کنید. با این حال، تجربه نشان میدهد که بهدلیل منابع محدود و نیاز به پردازش، بررسی و شناخت دادهها علاوهبر مهم بودن، بسیار زمانبر است. به همین دلیل، همانطور که در این مطلب از مجله فرادرس خواندیم، پاسخ دادن به پرسشهایی مانند دیتاست چیست و آشنایی با نحوه بهرهگیری از دادهها در یادگیری ماشین بسیار اهمیت دارد. در نهایت، دیتاستی ارزشمند و مفید است که هم به اندازه کافی جامع و هم از کیفیت بالا و استانداردی برخوردار باشد.
مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید

تشکر