توزیع لاپلاس (Laplace Distribution) – به زبان ساده
در میان توزیعها و متغیرهای تصادفی پیوسته، «توزیع لاپلاس» (Laplace Distribution) دارای کاربردهای زیادی است. در این نوشتار به بررسی این توزیع میپردازیم و در مورد خصوصیات آن بحث خواهیم کرد. از آنجایی که این توزیع برمبنای فاصله قدرمطلق خطاها (Absolute Difference) ساخته شده است، زمانی که میانه برآوردگر بهتری نسبت به میانگین برای نقطه مرکزی دادهها باشد، قادر است رفتار دادههای تصادفی را بهتر توصیف کند.
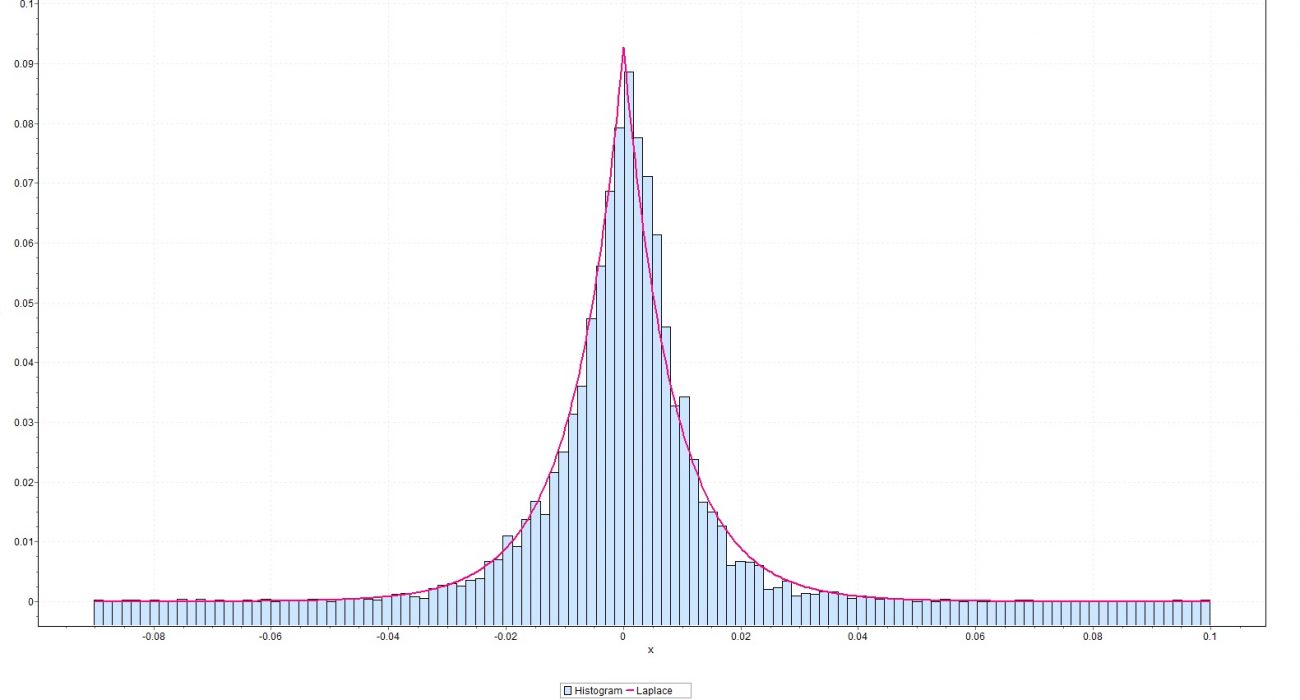


توزیع لاپلاس (Laplace Distribution)
توزیع لاپلاس را به قانون اول خطایهای لاپلاس نسبت میدهند. «پیر-سیمون لاپلاس» (Pierre-Simon Laplace) دانشمند و ریاضیدان فرانسوی قرن ۱۸، در پی تحقیقاتی که در مورد کاهش خطای برآوردها انجام میداد، این توزیع آماری را بررسی کرد. او در مقالهای که در سال 1774 منتشر کرد، نشان داده که فراوانی خطاها را میتوان به فرم یک تابع نمایی نشان داد. بعدها «جان کینس» (John Keynes) در سال 1901 نشان داد که توزیع لاپلاس، قدر مطلق خطا نسبت به نقطه میانه را کمینه میسازد.
به این توزیع، گاهی توزیع نمایی دوتایی (Double Exponential Distribution) گفته میشود. زیرا میتوان آن را به صورت دو تابع توزیع نمایی چسبیده به هم تصور کرد. نمودار تابع چگالی احتمال که در ادامه قابل مشاهده است، این موضوع را بهتر نشان میدهد.
تابع احتمال و توزیع تجمعی لاپلاس
اگر متغیر تصادفی دارای تابع چگالی احتمال به صورت زیر باشد، آن یک متغیر تصادفی با توزیع لاپلاس مینامند. در این صورت مینویسند: .
در این رابطه، را «پارامتر مکان» (Location Parameter) و را «پارامتر مقیاس» (Scale Parameter) مینامند.
نکته: اگر و باشد، توزیع لاپلاس از هر طرف (مجموعه مقادیر مثبت و منفی) شبیه دو توزیع نمایی با پارامتر و است.
تابع چگالی احتمال توزیع لاپلاس بسیار شبیه توزیع نرمال است. با این حال، اگر توزیع نرمال به صورت مربع اختلاف از میانگین بیان میشود، در توزیع لاپلاس، تراکم یا چگالی مقادیر به واسطه تفاوت قدر مطلق مقادیر حول میانه خواهد بود. در نتيجه توزيع لاپلاس با دمهای کشیدهتری نسبت به توزیع نرمال رسم میگردد.
در تصویر زیر تابع احتمال توزیع لاپلاس برای مقدارهای مختلف پارامترهایش دیده میشود.

در تصویر بالا دلیل نامگذاری این توزیع با توزیع نمایی دوتایی به وضوح دیده میشود. به نظر میرسد که در نقطه مرکزی یا پارامتر مکان، از سمت راست یک تابع نمایی منفی و در سمت چپ نیز یک تابع نمایی نمایی منفی دیگر رسم شده است. تابع توزیع تجمعی این توزیع احتمالی نیز به صورت زیر نوشته میشود.
$$\large F(x) = \int_{-\infty}^x \!\!f(u)\,\mathrm{d}u = \begin{cases} \frac12 \exp \left( \frac{x-\mu}{b} \right) & \mbox{if }x < \mu \\ \large 1-\frac12 \exp \left( -\frac{x-\mu}{b} \right) & \mbox{if }x \geq \mu \end{cases}$$مطالب مجله فرادرس را در جستجوی گوگل سریعتر ببینید